お腹.ヘッタ。

進捗つらぽよ

Packet replication and VXLAN forwarding with XDP devmaps

Packet replication and VXLAN forwarding with XDP devmaps

This article is translation for Japanese my article takeio.hatenablog.com

Motivation

I wrote this article after reading XDP_CLONE: Efficient In-Driver Packet Duplication for eBPF-Accelerated Systems, a paper presented at eBPF '26. In Section 1, on page 67, the authors describe packet replication with bpf_redirect_map() and BPF_F_BROADCAST. They then make this claim about modifying the copies:

the program has no way to rewrite each copy independently

Section 3 repeats the claim that the replicated packets cannot be modified.

That claim is incorrect. With devmap broadcast and a devmap egress program, XDP can already replicate packets and rewrite each copy independently.

BUM stands for broadcast, unknown unicast, and multicast. For example, an L2 network built with VXLAN or SRv6 may distribute BUM traffic to several peers over unicast. That requires a different outer destination for each copy, while keeping the original Ethernet frame unchanged. I use VXLAN as the example here.

I already knew XDP could do this, so the paper made me suspect that this use of devmaps was not widely known. When I asked an AI assistant, it suggested classifying packets in XDP and replicating them with bpf_clone_redirect() in TC. That works too, but TC operates on skbs, so I wanted to compare its performance with replication handled entirely in XDP. I decided to explain the existing XDP approach with working code and include measurements against an XDP + TC version.

For the code, see my goxdp-template repository. It started as a template for writing XDP programs and has gradually become a collection of runnable examples. It includes the VXLAN implementation used in this article, which may help when implementing BUM forwarding or giving an AI assistant concrete code to work with. If you find it useful, I'd appreciate a star.

Let's start with the simplest case: replicating a received frame without changing it.

How does basic broadcast work in XDP?

To broadcast a received frame, replicate it to the output interfaces registered in a devmap. Create a BPF_MAP_TYPE_DEVMAP map and redirect to it with BPF_F_BROADCAST:

#include <linux/bpf.h>
#include <linux/if_ether.h>

#include <bpf/bpf_helpers.h>

struct {
  __uint(type, BPF_MAP_TYPE_DEVMAP);
  __uint(max_entries, 64);
  __type(key, __u32);
  __type(value, __u32);
} tx_ports SEC(".maps");

SEC("xdp")
int xdp_broadcast(struct xdp_md* ctx) {
  void* data = (void*)(long)ctx->data;
  void* data_end = (void*)(long)ctx->data_end;

  if (data + sizeof(struct ethhdr) > data_end) return XDP_DROP;

  return bpf_redirect_map(&tx_ports, 0,
                          BPF_F_BROADCAST | BPF_F_EXCLUDE_INGRESS);
}

char __license[] SEC("license") = "Dual MIT/GPL";

User space populates the slots in tx_ports with the output interface indices. With two outputs other than the ingress interface, the kernel sends one identical copy to each. This program leaves the frame's MAC addresses, IP addresses, and TTL unchanged.

The two flags have different roles:

  • BPF_F_BROADCAST tells the kernel to replicate the frame to the outputs registered in the map. The key passed as the second argument is unused in this mode.
  • BPF_F_EXCLUDE_INGRESS excludes the receiving interface from the outputs. Even if that interface belongs to the group, the kernel does not send a copy back to it.

Broadcast here means replication to the outputs in the map. The flag does not change the Ethernet destination MAC address, so it also works with a unicast input frame. Separate devmaps for separate groups can provide multicast forwarding with a selected set of outputs. The kernel's devmap documentation describes this use.

Applying this to VXLAN requires choosing the replication targets and rewriting each copy. A VNI identifies a logical VXLAN network, and a VTEP is a VXLAN tunnel endpoint. Below, Outer means the outer VXLAN encapsulation headers, and Inner means the encapsulated Ethernet frame.

  • How do we select the output ports for each VNI?
    • Putting all ports in one devmap would also send copies to ports belonging to other VNIs.
  • How do we change the VXLAN destination for each copy?
    • Delivering BUM traffic to several VTEPs over unicast requires an identical Inner and a different Outer destination for each copy.

Let's work through these two questions in order.

How do we select the output ports for each VNI?

Create a devmap for each VNI and select the one matching the received packet's VNI. This limits replication to that VNI's members. To select the devmap, use a map-in-map, whose values reference other maps.

A frame in VNI 100 should reach the members of VNI 100, and a frame in VNI 200 should reach the members of VNI 200. Select the devmap before calling bpf_redirect_map() with BPF_F_BROADCAST:

  • The outer map, vni_groups, is a BPF_MAP_TYPE_HASH_OF_MAPS keyed by VNI.
  • Each inner map is a BPF_MAP_TYPE_DEVMAP_HASH containing only that VNI's members.
    • This example uses the output ifindex as the inner key and stores the output ifindex and egress program in the value.

The map definitions are in xdp_vxlan.c. The Go implementation of UpdateMembers() creates and registers the per-VNI devmaps.

During forwarding, look up the VNI's devmap, then broadcast through it:

void *members = bpf_map_lookup_elem(&vni_groups, &vni);
if (!members)
    return XDP_DROP;

return bpf_redirect_map(members, 0,
                       BPF_F_BROADCAST | BPF_F_EXCLUDE_INGRESS);

This call sends copies to the outputs registered in the devmap referenced by members. Although the redirect call ignores its key argument, selecting the map by VNI has already restricted the outputs. The kernel's map-in-map documentation explains how to obtain a reference to an inner map.

In the diagram below, access1 and access2 face endpoints, while uplink0 carries VXLAN traffic. The outer map references a separate devmap for each VNI. Registering uplink0 in both maps does not create a path from VNI 100 to access2.

flowchart LR
    accTitle: VNI-scoped BUM replication with map-in-map
    accDescr: The outer vni_groups hash maps VNI 100 and VNI 200 to separate devmaps. Each devmap contains one access port and the shared uplink0. Broadcast uses only the selected devmap, so the shared uplink does not merge the VNI groups. The arrows show map references and membership.
    subgraph outer["vni_groups: HASH_OF_MAPS"]
        v100["key: VNI 100"]
        v200["key: VNI 200"]
    end
    v100 -->|map reference| a["DEVMAP_HASH A<br/>VNI 100 members"]
    v200 -->|map reference| b["DEVMAP_HASH B<br/>VNI 200 members"]
    a --> access1["access1<br/>VNI 100"]
    a --> uplink["uplink0<br/>shared tunnel interface"]
    b --> uplink
    b --> access2["access2<br/>VNI 200"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class v100,v200,a,b map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

The same output ifindex can belong to several per-VNI devmaps without merging their replication groups. For example, VNI 100 and VNI 200 can share uplink0 while retaining separate access ports. The destination VTEP on that uplink can differ by VNI, so choosing a port also requires rewriting the Outer headers.

How do we change the VXLAN destination for each copy?

Use an egress program associated with the devmap entry to rewrite each copy. In the basic example, each entry contained only an output ifindex, and the kernel sent the frame unchanged. Now register an XDP program alongside that ifindex to run before transmission. This is a devmap egress program.

The ingress XDP program still requests replication with bpf_redirect_map() and BPF_F_BROADCAST. After distributing the frame to the outputs, the kernel runs the egress program registered in each output's entry before sending that copy. The program can rewrite the Outer destination there.

The same egress program can serve several entries. It reads ctx->egress_ifindex to identify the output interface for the current copy. Consider two output interfaces named p2 and p3. When the kernel replicates a frame in one VNI to both outputs, this field contains p2's ifindex for the p2 copy and p3's ifindex for the p3 copy.

The program can use that value to set the Outer destination IP to 192.0.2.2 for p2 and 192.0.3.2 for p3. Rewriting the p2 copy does not affect the p3 copy.

Change the devmap value type from __u32 to struct bpf_devmap_val, which holds both the ifindex and the program. Its bpf_prog.fd field takes the file descriptor of an XDP program with attach type BPF_XDP_DEVMAP. On the BPF side, define that program with SEC("xdp/devmap").

In Go, the map value consists of two 32-bit values: the output ifindex and the program FD. Here, members is the selected VNI's devmap, and egress is the loaded egress program:

value := [2]uint32{uint32(ifindex), uint32(egress.FD())}
if err := members.Update(value[0], value, ebpf.UpdateAny); err != nil {
    return err
}

The sample performs this registration in UpdateMembers().

Existing kernels already support running a separate XDP program on the replicated frames. For the replication and program execution, see dev_map_enqueue_multi() and dev_map_bpf_prog_run() in Linux 7.3.

This implementation looks up the peer VTEP by VNI and ctx->egress_ifindex, then rewrites the Outer source and destination addresses. The following excerpt from vxlan_rewrite() runs after header validation and the peer lookup:

__builtin_memcpy(eth->h_source, port.mac, ETH_ALEN);
__builtin_memcpy(eth->h_dest, target.mac, ETH_ALEN);
ip->saddr = port.local_ip;
ip->daddr = target.remote_ip;
checksum(ip);
return XDP_PASS;

Returning XDP_PASS from a devmap egress program continues transmission through the output selected by the devmap. Unlike XDP_PASS at ingress, it does not pass the packet to the Linux network stack. Returning XDP_DROP discards only the copy for that output.

The program rewrites only Outer; Inner stays identical across the copies. The UDP and VXLAN headers can also share common values. The Outer UDP source port comes from an Inner flow hash, keeping it stable within a flow while allowing different flows to use different values.

Each tunnel egress adds Outer after replication and sends the same Inner to a different VTEP:

flowchart TB
    accTitle: VXLAN replication with per-output rewriting
    accDescr: One inner frame is replicated to two tunnel outputs and one access output. Tunnel copies get different outer IP addresses while the inner frame remains identical.
    inner["Inner F"] --> prepare["Prepare Outer template<br/>header_cache[key]"]
    prepare --> group["DEVMAP broadcast<br/>Inner F + metadata"]
    group --> b["p2: egress rewrite<br/>attach Outer"]
    group --> c["p3: egress rewrite<br/>attach Outer"]
    group --> access["Access egress<br/>remove metadata"]
    b --> packetB["Outer dst: 192.0.2.2<br/>UDP / VXLAN / Inner F"]
    c --> packetC["Outer dst: 192.0.3.2<br/>UDP / VXLAN / Inner F"]
    access --> local["Access output<br/>Inner F"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class prepare,b,c,access process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class group map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

This sample configures one unicast peer for each (VNI, output ifindex) pair. It therefore uses different output interfaces to replicate traffic in the same VNI to several peers. That is a constraint of this sample's design; the kernel does not require devmap keys to be ifindices. Replicating traffic in the same VNI to several VTEPs through a single output interface would require an additional way to identify the destination VTEP for each copy.

We now have both output selection and per-copy rewriting. The complete forwarding path puts them together.

The replication and rewrite pipeline

  • A per-VNI devmap restricts the outputs, and the egress program registered in each entry rewrites its copy to send the same Inner to several VTEPs.
  • Ingress selects the replication group; devmap egress assembles the packet for each output.
flowchart TB
    accTitle: VNI selection, replication, and per-copy rewriting
    accDescr: Ingress selects a VNI and its devmap. Broadcast replicates the Inner frame to the group's members. Each tunnel egress adds Outer headers and rewrites its destination, while access egress sends the original Inner frame.
    input["Received frame"] --> ingress["Ingress XDP<br/>validate / select VNI"]
    ingress --> group["DEVMAP for selected VNI<br/>replicate to members"]
    group -->|"tunnel copy"| tunnel["Devmap egress<br/>attach Outer<br/>rewrite destination"]
    group -->|"access copy"| access["Devmap egress<br/>keep Inner unchanged"]
    tunnel --> peers["Unicast to each VTEP<br/>same Inner / different Outer"]
    access --> endpoint["Access output<br/>original Inner"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class ingress,tunnel,access process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class group map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

This leaves two implementation questions: where to prepare the common Outer headers, and how to pass the VNI and processing instructions from ingress to each egress program. The sample uses the following design; other implementations are possible.

Passing data and processing instructions between programs

Each egress program needs header data for rewriting, along with the operation to perform and its arguments. Before replication, the sample saves a common header template in a map and places the operation ID and arguments in 32 bytes of data_meta.

Location Contents
First 16 bytes of data_meta program (operation ID) and magic (validation marker), 64 bits each.
Last 16 bytes of data_meta vni, flags, inner_len, and flow_hash, 32 bits each.
header_cache The common Ethernet, IPv4, UDP, and VXLAN header template.

Ingress starts forwarding with PROGRAM_FORWARD and switches to PROGRAM_REWRITE before replication. At egress, a shared dispatcher validates the command length, magic, and operation ID, then tail-calls the rewrite handler. It drops the packet if the command is invalid or the handler is missing.

The packet body remains Inner during replication. Only the tunnel copies receive the 50-byte Outer template retrieved from the map:

%%{init: {"theme":"base","look":"classic","fontFamily":"DejaVu Sans, sans-serif","themeVariables":{"lineColor":"#666666","clusterBkg":"#fafafa","clusterBorder":"#aaaaaa","edgeLabelBackground":"#ffffff"},"flowchart":{"htmlLabels":false,"curve":"linear"},"themeCSS":".edgeLabel rect, .edgeLabel .background { fill: #ffffff !important; opacity: 1 !important; } .labelBkg { background-color: #ffffff !important; }"}}%%
flowchart TB
    accTitle: Shared Outer template and metadata handoff
    accDescr: A 1514-byte Inner frame stays unchanged while its shared 50-byte Outer template is saved in a Per-CPU LRU map. Devmap checks output MTUs and replicates the Inner frame with a 32-byte command. Access egress keeps the Inner frame. Tunnel egress retrieves or rebuilds the template, checks the final length, prepends Outer, and rewrites addresses.
    inner["Inner frame: 1514 B"] --> prepare["Ingress forwarding<br/>prepare shared Outer template"]
    prepare -. "store template" .-> cache[("Per-CPU LRU: header_cache<br/>key: (VNI, Inner length)<br/>Outer template: 50 B")]
    prepare -->|"32 B metadata<br/>REWRITE + arguments"| group["DEVMAP<br/>check MTU per output<br/>replicate Inner frame"]
    group -->|"access MTU: 1500"| access["Access egress<br/>Inner frame: 1514 B"]
    group -->|"tunnel MTU: 1600"| tunnel["Tunnel egress<br/>check final length<br/>prepend 50 B / rewrite"]
    cache -. "read / validate<br/>rebuild on miss" .-> tunnel
    tunnel --> output["Outer 50 B + Inner 1514 B<br/>frame: 1564 B<br/>Outer IP packet: 1550 B"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class prepare,access,tunnel process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class group,cache map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

The devmap checks the output MTU before running the egress program, so the sample leaves Outer off the packet until after replication. Access copies undergo the MTU check at their Inner length. For tunnel copies, the egress program also checks the final length including Outer. The 50-byte VXLAN_OVERHEAD consists of 14 bytes of Ethernet, 20 bytes of IPv4, 8 bytes of UDP, and 8 bytes of VXLAN.

In vxlan_rewrite(), the program removes the 32-byte command, reserves 50 bytes at the front, and copies in the template. In this excerpt, header already contains the retrieved and validated template:

if (bpf_xdp_adjust_meta(ctx, sizeof(struct xdp_command)) ||
    bpf_xdp_adjust_head(ctx, -VXLAN_OVERHEAD))
  return XDP_DROP;
data = (void*)(long)ctx->data;
end = (void*)(long)ctx->data_end;
if (data + VXLAN_OVERHEAD > end) return XDP_DROP;
__builtin_memcpy(data, header.bytes, VXLAN_OVERHEAD);

So far, the forwarding path has assumed that the VNI is already known. A VLAN trunk needs an input classification step before selecting the replication group.

BUM isolation with VLANs and VNIs

For a trunk carrying several VLANs, the sample selects a VNI using the ingress ifindex and VLAN ID (VID), then replicates BUM traffic through that VNI's devmap. One trunk can map VID 10 to VNI 100 and VID 20 to VNI 200. Because the lookup includes the ingress ifindex, another port can map VID 10 to VNI 300 without mixing its replication targets with VNI 100.

Configure these mappings in each port's vlans list. The following trunk accepts two VIDs. Each VNI's group includes the trunk and the required output ports:

{
  "device": "trunk0",
  "vlans": [
    {"vid": 10, "vni": 100},
    {"vid": 20, "vni": 200}
  ]
}

Ingress validates the 802.1Q tag, extracts the VID, and looks up the VNI in vlan_bindings:

struct vlan_key key = {.ifindex = ingress, .vid = vid};
__u32* binding = bpf_map_lookup_elem(&vlan_bindings, &key);
if (!binding) return XDP_DROP;
vni = *binding;

It then selects the devmap from vni_groups using that VNI. The VNI travels in metadata, while egress reads the VID from the tag retained in Inner. This keeps the command within the same 32-byte metadata area.

Before sending through a shared trunk, egress checks both VNI membership and Inner's VID. Even if the trunk belongs to VNI 100 and VNI 200, a VNI 100 copy must carry VID 10. It will not send a VNI 100 packet carrying VID 20 through that trunk. The check uses the VNI, output ifindex, and expected VID registered in port_vnis.

For received VXLAN traffic, ingress removes Outer and forwards Inner to access members of the same VNI. Split horizon prevents loops by keeping that traffic from being forwarded to other tunnels. The same egress checks apply to the decapsulated Inner. Before decapsulation, ingress also checks that the receiving tunnel's ifindex and the VXLAN VNI form an allowed pair. Configuring a VNI somewhere on the host does not authorize receiving it on a different tunnel port.

%%{init: {"theme":"base","look":"classic","fontFamily":"DejaVu Sans, sans-serif","themeVariables":{"lineColor":"#666666","clusterBkg":"#fafafa","clusterBorder":"#aaaaaa","edgeLabelBackground":"#ffffff"},"flowchart":{"htmlLabels":false,"curve":"linear"},"themeCSS":".edgeLabel rect, .edgeLabel .background { fill: #ffffff !important; opacity: 1 !important; } .labelBkg { background-color: #ffffff !important; }"}}%%
flowchart TB
    accTitle: VLAN-scoped BUM forwarding across VXLAN
    accDescr: A tagged frame on trunk0 selects VNI 100 for VID 10 or VNI 200 for VID 20. Each devmap sends local copies and a tunnel copy with its original inner tag. The remote VTEP checks tunnel admission, decapsulates, and validates output membership and the inner VID before sending to a shared trunk.
    input["trunk0: one 802.1Q frame<br/>Inner VID 10 or VID 20"] --> classify["vlan_bindings<br/>(ingress ifindex, VID) → VNI"]
    classify -->|VID 10| a["vni_groups[100]<br/>DEVMAP broadcast"]
    classify -->|VID 20| b["vni_groups[200]<br/>DEVMAP broadcast"]
    a --> local10["Local VID 10 output<br/>Inner unchanged"]
    b --> local20["Local VID 20 output<br/>Inner unchanged"]
    a --> tunnel10["Shared uplink<br/>Outer VNI 100 / Inner VID 10"]
    b --> tunnel20["Shared uplink<br/>Outer VNI 200 / Inner VID 20"]
    decap["Remote VTEP ingress<br/>check allowed tunnel / VNI<br/>then decapsulate"] --> policy["Remote egress: port_vnis<br/>(VNI, egress ifindex)<br/>require expected Inner VID"]
    policy -->|Match| output["Remote trunk<br/>Inner tag unchanged"]
    policy -->|Mismatch| drop["Drop this output copy"]
    tunnel10 --> decap
    tunnel20 --> decap
    class drop rejected;
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    classDef rejected fill:#ffffff,stroke:#666666,color:#222222,stroke-dasharray:4 3;
    class classify,decap,policy process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class a,b map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

The branches represent separate input frames with VID 10 or VID 20; each frame selects one VNI. Tunnel copies retain the Inner tag, and the receiving VTEP checks the output port's VNI and VID.

This implementation forwards frames with a single 802.1Q tag and preserves that tag. VLAN-aware ports in the same VNI must use the same VID, and the peer VTEP must accept it. The sample does not add or remove tags or translate VIDs. It also rejects configurations that mix fixed-VNI ports and VLAN-aware ports within one VNI. Configurations using only fixed-VNI ports continue to forward Inner tags unchanged.

VLAN-aware ports drop unregistered VIDs, untagged frames, VID 0 and 4095, truncated tags, 802.1ad, and double tagging. They preserve the PCP and DEI bits without using them for classification. If RX VLAN stripping on a physical NIC removes the tag, the program treats the frame as untagged and drops it. Forwarding through a VLAN-aware port therefore requires disabling stripping.

UpdateMembers() can remove members from an initially configured group and restore them later. These updates do not change VLAN classification or tunnel admission. Changing the VID-to-VNI mappings requires reloading the configuration. The VLAN documentation contains the complete JSON configuration and admission rules.

With the forwarding path defined, we can check it in a network namespace topology built from veth pairs.

Testing in network namespaces

I ran the sample with three VTEPs and endpoints in VNI 100 and VNI 200, connected by veth pairs. XDP handles both encapsulation and decapsulation, without a Linux bridge or Linux VXLAN device. Each VTEP and endpoint runs in its own network namespace:

%%{init: {"theme":"base","look":"classic","fontFamily":"DejaVu Sans, sans-serif","themeVariables":{"lineColor":"#666666","clusterBkg":"#fafafa","clusterBorder":"#aaaaaa","edgeLabelBackground":"#ffffff"},"flowchart":{"htmlLabels":false,"curve":"linear"},"themeCSS":".edgeLabel rect, .edgeLabel .background { fill: #ffffff !important; opacity: 1 !important; } .labelBkg { background-color: #ffffff !important; }"}}%%
flowchart LR
    accTitle: Three-VTEP VXLAN network namespace topology
    accDescr: VTEP A connects to VTEPs B and C through two direct veth underlay links. Each VTEP has separate VNI 100 and VNI 200 access endpoints, and A has one extra VNI 100 access endpoint. Every endpoint and VTEP has its own namespace.
    a100["a-100 namespace<br/>VNI 100"] ---|"eth0 / p0"| A["VTEP A namespace<br/>goxdp / XDP VXLAN"]
    a200["a-200 namespace<br/>VNI 200"] ---|"eth0 / p1"| A
    alocal["a-local namespace<br/>VNI 100"] ---|"eth0 / p4"| A
    A ---|"p2 / p2<br/>192.0.2.1 / 192.0.2.2<br/>VXLAN over veth<br/>MTU 1600"| B["VTEP B namespace<br/>goxdp / XDP VXLAN"]
    A ---|"p3 / p2<br/>192.0.3.1 / 192.0.3.2<br/>VXLAN over veth<br/>MTU 1600"| C["VTEP C namespace<br/>goxdp / XDP VXLAN"]
    B ---|"p0 / eth0"| b100["b-100 namespace<br/>VNI 100"]
    B ---|"p1 / eth0"| b200["b-200 namespace<br/>VNI 200"]
    C ---|"p0 / eth0"| c100["c-100 namespace<br/>VNI 100"]
    C ---|"p1 / eth0"| c200["c-200 namespace<br/>VNI 200"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class A,B,C process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;

I confirmed BUM delivery within each VNI, including delivery over VXLAN to endpoints behind the remote VTEPs. The test environment used Linux 7.0.0-38-generic and veth. The testing documentation includes the test details and commands.

With BUM forwarding working in XDP, the next question is how it performs against replication in TC.

Performance against XDP + TC

I compared the default --backend xdp with --backend tc using the same forwarding configuration. The XDP + TC version validates and decapsulates packets in XDP, returns XDP_PASS to hand them off as skbs, then replicates them in TC.

TC sends the access copies first, adds Outer once for the tunnel copies, and rewrites the destination for each peer. Both versions share the logic for VLAN-to-VNI classification and VNI/VID validation.

%%{init: {"theme":"base","look":"classic","fontFamily":"DejaVu Sans, sans-serif","themeVariables":{"lineColor":"#666666","clusterBkg":"#fafafa","clusterBorder":"#aaaaaa","edgeLabelBackground":"#ffffff"},"flowchart":{"htmlLabels":false,"curve":"linear"},"themeCSS":".edgeLabel rect, .edgeLabel .background { fill: #ffffff !important; opacity: 1 !important; } .labelBkg { background-color: #ffffff !important; }"}}%%
flowchart TB
    accTitle: XDP and XDP plus TC VXLAN replication paths
    accDescr: Both backends classify and decapsulate in XDP. The XDP backend replicates through a devmap and rewrites each tunnel copy in an egress program. The TC backend passes an skb to TC, sends access copies first, prepends Outer once, and rewrites each tunnel destination. Both preserve the Inner frame.
    subgraph xdp["XDP backend"]
        direction TB
        xi["Ingress XDP<br/>validate / decap"] --> group["DEVMAP broadcast"]
        group --> rewrite["Per-copy egress XDP<br/>attach Outer / rewrite"]
        rewrite --> xo["Tunnel copies<br/>same Inner / varied Outer"]
    end
    subgraph tc["XDP + TC backend"]
        direction TB
        ti["Ingress XDP<br/>validate / decap"] --> pass["XDP_PASS<br/>create skb"]
        pass --> clone["TC ingress<br/>access copies first<br/>prepend Outer once"]
        clone --> target["Rewrite each destination<br/>N-1 clones + redirect"]
        target --> tout["Tunnel copies<br/>same Inner / varied Outer"]
    end
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class xi,rewrite,ti,pass,clone,target process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class group map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

The XDP version replicates through a devmap and processes each copy in its egress program. The XDP + TC version performs the rewriting and replication at TC ingress.

In this veth setup, the XDP version achieved about 1.6 to 1.8 times the aggregate receive throughput of XDP + TC. Using four XDPerf workers and four veth queues, I replicated 64 UDP flows in one VNI to two unicast VTEPs. The table lists the median aggregate receive rate across three runs, measured with binaries built before VLAN support was added.

Input frame length XDP (Mpps) XDP + TC (Mpps) XDP / TC
64 bytes 1.861 1.056 1.76x
1514 bytes 1.454 0.896 1.62x

These measurements include the sender, forwarding process, and receivers running on the same KVM host. They do not establish physical NIC performance, a loss-free forwarding limit, or a performance difference against XDP_CLONE, which I have not measured. The benchmark report contains the setup and raw data.

Closing thoughts

Existing XDP supports BUM replication with devmap broadcast and an egress program, including sending the same Inner with different Outer headers. I confirmed that behavior in network namespaces. The paper states that each copy cannot be rewritten independently. A devmap egress program makes this possible with existing XDP.

XDP_CLONE may still be more convenient in some cases, with direct access to a copy index and the ability to pass the original packet directly to the stack. I'd like to see future comparisons of performance and usability against the existing approach.
XDPでBUMを運べるわけないじゃん、ムリムリ!(※ムリじゃなかった!?)

目的

XDP_CLONE: Efficient In-Driver Packet Duplication for eBPF-Accelerated Systemsという論文が eBPF'26で出ていました、一章では、bpf_redirect_map()とBPF_F_BROADCASTによる複製を説明しています。

その直後に続く、個別の書き換えについての記述を抜粋します。

the program has no way to rewrite each copy independently

(訳: そのプログラムには、各コピーを個別に書き換える手段がない。)

同様に3章でも、複製したパケットを変更できないという説明を繰り返しています。

しかし、この説明は誤りです。 devmap broadcastとdevmap egress programを組み合わせれば、既存のXDPでもパケットを複製し、コピーごとに書き換えられます。

BUMは、ブロードキャスト、宛先不明のユニキャスト、マルチキャストをまとめた呼び方です。 例えば、VXLANやSRv6でL2ネットワークを構成し、BUMを複数の対向へユニキャストで配信する場面で、この書き換えが必要になります。

元のEthernetフレームは同じでも、コピーごとに外側の宛先を変える必要があります。 この記事ではVXLANを例に、この処理を実装します。

私は以前からXDPでこうした処理を実現できると知っていたので、論文の説明を読み、この使い方が十分に知られていないのだと感じました。 実際、私がAIに尋ねたときにも、XDPで分類し、TCのbpf_clone_redirect()で複製する構成が提案されました。 その構成でも動作しますが、TCではskbを扱うため、XDPで複製まで完結させる場合との性能差も気になります。 そこで、既存のXDPによる複製と個別の書き換えを、動くコードで説明することにしました。

性能については、TC併用版も用意し、後半で測定結果を示します。

説明より先にコードが欲しい人は、拙作のgoxdp-templateを見てください。 XDPを書くためのテンプレートとして作り始めましたが、最近は動くサンプル集に近くなっています。 今回のブログの元になったVXLANの実装も置いているので、BUMを実装するときや、AIに具体的なコードを渡して相談するときの参考になると思います。 参考になったら、スターを付けてもらえるとうれしいです。

github.com

まずは、受信フレームをそのまま複製する基本形から見ていきましょう。

XDPで単純なBroadcastを実現するには?

基本形は、devmapに登録した出力インターフェースへ、受信フレームをそのまま複製して送る処理です。 BPF_MAP_TYPE_DEVMAPのマップを用意し、BPF_F_BROADCASTを指定してリダイレクトします。 次のプログラムが、その基本形になります。

#include <linux/bpf.h>
#include <linux/if_ether.h>

#include <bpf/bpf_helpers.h>

struct {
  __uint(type, BPF_MAP_TYPE_DEVMAP);
  __uint(max_entries, 64);
  __type(key, __u32);
  __type(value, __u32);
} tx_ports SEC(".maps");

SEC("xdp")
int xdp_broadcast(struct xdp_md* ctx) {
  void* data = (void*)(long)ctx->data;
  void* data_end = (void*)(long)ctx->data_end;

  if (data + sizeof(struct ethhdr) > data_end) return XDP_DROP;

  return bpf_redirect_map(&tx_ports, 0,
                          BPF_F_BROADCAST | BPF_F_EXCLUDE_INGRESS);
}

char __license[] SEC("license") = "Dual MIT/GPL";

ユーザーランドからtx_portsの各スロットへ出力先のifindexを設定すると、そのインターフェースが複製先になります。 例えば、受信ポート以外の二つの出力先を登録すれば、同じ内容のフレームをそれぞれに一つずつ送ります。 受信したフレームのMACやIP、TTLを変更する処理は入れていません。

ここで指定した二つのフラグには、次の意味があります。

  • BPF_F_BROADCASTを指定すると、カーネルはマップに登録された出力へフレームを複製します。このとき第2引数のキーは使いません。
  • BPF_F_EXCLUDE_INGRESSを指定すると、受信したインターフェースを送信先から外します。受信ポートをグループに含めても、そこへ送り返すコピーは作りません。

ここでいうbroadcastは、マップに登録した出力への複製を指します。 Ethernetの宛先MACを変更する指定ではないため、入力フレームの宛先がユニキャストでも使えます。 グループごとにdevmapを用意すれば、送信先をグループで選ぶマルチキャスト転送も構成できます。 この使い方は、カーネルのdevmapドキュメントでも説明されています。

docs.kernel.org

この基本形をVXLANへ応用するには、複製先の選択と、コピーごとの書き換えを考える必要があります。 VNIはVXLANの論理ネットワークを識別する値、VTEPはVXLANトンネルの端点です。 以下では、VXLANの外側のヘッダーをOuter、内側のEthernetフレームをInnerと呼びます。

  • 課題1: VNIごとに複製先のポートを選ぶには?
    • 全ポートを一つのdevmapへ入れると、別のVNIに属するポートへもコピーを送ってしまいますのでなんとかする必要があります。
  • 課題2: コピーごとにVXLANの送信先を変えるには?
    • 複数のVTEPへユニキャストでBUMを配信するとき、Innerは同じ内容に保ちつつも、Outerの宛先は、コピーごとに変える必要があります。

では、この二つの課題をどう解決するか、順に見ていきましょう。

課題1: VNIごとに複製先のポートを選ぶには?

これの解決方法は、VNIごとにdevmapを作り、受信したパケットのVNIに対応するマップを選ばせて、複製先をそのVNIのメンバーに限定させることで解決させます。

具体的には マップの値として別のマップへの参照を持つmap-in-mapを使うことです。

まずやりたいことを考えてみましょう。VNI 100のフレームはVNI 100のメンバーへ、VNI 200のフレームはVNI 200のメンバーへ送ります。 BPF_F_BROADCASTで複製するときに全ポートへ送らないよう、呼び出し前に対象のdevmapを選んでおきます。

このmapはmap-in-mapになっており、 - 外側のvni_groupsはBPF_MAP_TYPE_HASH_OF_MAPSで、VNIをキーに内側のマップを選びます。 - 内側はBPF_MAP_TYPE_DEVMAP_HASHで、そのVNIのメンバーだけを登録します。 - 内側のキーには出力ifindexを使い、値には出力ifindexとegress programを持たせます。

マップの定義はxdp_vxlan.c、VNIごとのdevmapの作成と登録はGo側のUpdateMembers()にあります。

転送時には、対象VNIのdevmapを取り出してからBPF_F_BROADCASTを指定します。

void *members = bpf_map_lookup_elem(&vni_groups, &vni);
if (!members)
    return XDP_DROP;

return bpf_redirect_map(members, 0,
                       BPF_F_BROADCAST | BPF_F_EXCLUDE_INGRESS);

この呼び出しでは、membersが指すdevmapに登録された出力へコピーを送ります。 第2引数のキーを使わなくても、先にVNIでマップを選ぶことで複製先を限定できます。 内側のマップへの参照を取得する方法は、カーネルのmap-in-mapドキュメントにも説明されています。

イメージとしては以下の様な図になります。

外側のマップがVNIごとのdevmapを参照し、各devmapがそのVNIの出力を保持し、access1とaccess2は端末側、uplink0はVXLANの送受信に使うインターフェースです。 同じuplink0を両方に登録しても、VNI 100からaccess2へのコピーは作りません。

flowchart LR
    accTitle: VNI-scoped BUM replication with map-in-map
    accDescr: The outer vni_groups hash maps VNI 100 and VNI 200 to separate devmaps. Each devmap contains one access port and the shared uplink0. Broadcast uses only the selected devmap, so the shared uplink does not merge the VNI groups. The arrows show map references and membership.
    subgraph outer["vni_groups: HASH_OF_MAPS"]
        v100["key: VNI 100"]
        v200["key: VNI 200"]
    end
    v100 -->|map reference| a["DEVMAP_HASH A<br/>VNI 100 members"]
    v200 -->|map reference| b["DEVMAP_HASH B<br/>VNI 200 members"]
    a --> access1["access1<br/>VNI 100"]
    a --> uplink["uplink0<br/>shared tunnel interface"]
    b --> uplink
    b --> access2["access2<br/>VNI 200"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class v100,v200,a,b map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

同じ出力ifindexを複数VNIのdevmapへ登録しても、各VNIの複製先は別々に管理できます。

例えばuplink0をVNI 100と200で共有しながら、それぞれのVNIに属するaccessポートを分けられます。 ただし、uplink0へ出すコピーの宛先VTEPはVNIごとに異なるため、ポートの選択に加えてOuterの書き換えも必要になります。

課題2: コピーごとにVXLANの送信先を変えるには?

これの解決方法は、コピーごとの書き換えには、devmapに関連付けたegress programを使います。

基本形では、devmapの値に出力先のifindexだけを登録し、受信フレームをそのまま複製して送りました。 コピーごとに書き換えるには、出力先のifindexに加え、送信前に実行するXDPプログラムを同じエントリーへ登録します。 このプログラムがdevmap egress programです。

受信時のXDPプログラムは、基本形と同じくbpf_redirect_map()とBPF_F_BROADCASTで複製を指示します。 カーネルは各出力へフレームを振り分けた後、各コピーの送信前に、その出力のエントリーに登録したegress programを実行します。 そこでOuterの宛先などを書き換えます。

同じegress programを複数のエントリーに登録して使えます。 プログラム内では、ctx->egress_ifindexから、そのコピーがどのインターフェースへ送られるかを調べられます。 例えば、複製先の二つの出力インターフェースをp2とp3とします。 同じVNIのフレームを両方へ複製すると、p2向けのコピーではこの値がp2のifindex、p3向けではp3のifindexになります。

その値に応じて、p2向けのOuterの宛先IPを192.0.2.2、p3向けを192.0.3.2に変えられます。 p2向けのコピーを書き換えても、p3向けのコピーの内容には影響しません。

マップ定義の値の型も、基本形の__u32から、ifindexとプログラムを持つstruct bpf_devmap_valへ変えます。 この構造体のbpf_prog.fdに、アタッチタイプがBPF_XDP_DEVMAPのXDPプログラムを指定します。 BPF側では、このプログラムをSEC("xdp/devmap")で定義します。

Goから登録する場合、devmapの値は出力ifindexとプログラムFDの二つの32ビット値になります。 次の例のmembersは対象VNIのdevmap、egressはロード済みのegress programを指します。

value := [2]uint32{uint32(ifindex), uint32(egress.FD())}
if err := members.Update(value[0], value, ebpf.UpdateAny); err != nil {
    return err
}

この登録処理は、Go側のUpdateMembers()で行っています。

複製したフレームに対して別のXDPプログラムを実行する仕組みは、既存カーネルに含まれています。 複製とプログラム実行は、Linux 7.3のdev_map_enqueue_multi()とdev_map_bpf_prog_run()でも確認できます。

今回の実装では、VNIとctx->egress_ifindexの組から相手のVTEPを検索し、Outerの送信元と宛先を書き換えます。 次のコードは、ヘッダーの検証とpeerの検索を終えた後の、vxlan_rewrite()の書き換え部分です。

__builtin_memcpy(eth->h_source, port.mac, ETH_ALEN);
__builtin_memcpy(eth->h_dest, target.mac, ETH_ALEN);
ip->saddr = port.local_ip;
ip->daddr = target.remote_ip;
checksum(ip);
return XDP_PASS;

ここで返すXDP_PASSは、devmapで選んだ出力への送信を続ける指示です。 受信時のXDPプログラムで返す場合とは意味が異なり、Linuxのネットワークスタックへ渡す処理ではありません。 XDP_DROPを返すと、その出力向けのコピーを破棄します。

書き換えの対象はOuterだけで、Innerフレームは各コピーで同じ内容を保ちます。 UDPとVXLANのヘッダーも共通にできます。 Outer UDP送信元ポートはInnerのフローハッシュから決めるため、同じフローでは安定し、異なるフローでは値を変えられます。

一旦図で見てみましょう。 このように複製後の各egressでOuterを付け、同じInnerを異なるVTEPへ送ります。

flowchart TB
    accTitle: VXLAN replication with per-output rewriting
    accDescr: One inner frame is replicated to two tunnel outputs and one access output. Tunnel copies get different outer IP addresses while the inner frame remains identical.
    inner["Inner F"] --> prepare["Prepare Outer template<br/>header_cache[key]"]
    prepare --> group["DEVMAP broadcast<br/>Inner F + metadata"]
    group --> b["p2: egress rewrite<br/>attach Outer"]
    group --> c["p3: egress rewrite<br/>attach Outer"]
    group --> access["Access egress<br/>remove metadata"]
    b --> packetB["Outer dst: 192.0.2.2<br/>UDP / VXLAN / Inner F"]
    c --> packetC["Outer dst: 192.0.3.2<br/>UDP / VXLAN / Inner F"]
    access --> local["Access output<br/>Inner F"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class prepare,b,c,access process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class group map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

現在のサンプルでは、VNIと出力ifindexの組ごとに一つのunicast peerを設定します。

同じVNIのフレームを複数peerへ複製するために、異なる出力インターフェースを使っています。 これはサンプルの構成上の制約であり、カーネルがdevmapのキーをifindexに限定しているわけではありません。 同じVNIから同じ出力インターフェースを通して複数VTEPへ複製するには、コピーごとに宛先VTEPを識別する仕組みを追加する必要があります。

これで、複製先の選択とコピーごとの書き換えがそろいました。 二つの処理をつないだ全体像を確認してみましょう。

複製と書き換えをつないだ全体像

ざっくり言葉でまとめると、、、

  • VNIごとのdevmapで複製先を限定し、各エントリーに登録したegress programでコピーを書き換えれば、同じInnerを複数のVTEPへ送れます
  • ingressが複製先のグループを選び、devmap egressが各出力向けにパケットを組み上げます

図としてはこの様な感じで、ingressで対象VNIのdevmapを選び、複製後の各egressで出力先に応じた処理を行います。

flowchart TB
    accTitle: VNI selection, replication, and per-copy rewriting
    accDescr: Ingress selects a VNI and its devmap. Broadcast replicates the Inner frame to the group's members. Each tunnel egress adds Outer headers and rewrites its destination, while access egress sends the original Inner frame.
    input["Received frame"] --> ingress["Ingress XDP<br/>validate / select VNI"]
    ingress --> group["DEVMAP for selected VNI<br/>replicate to members"]
    group -->|"tunnel copy"| tunnel["Devmap egress<br/>attach Outer<br/>rewrite destination"]
    group -->|"access copy"| access["Devmap egress<br/>keep Inner unchanged"]
    tunnel --> peers["Unicast to each VTEP<br/>same Inner / different Outer"]
    access --> endpoint["Access output<br/>original Inner"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class ingress,tunnel,access process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class group map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

ここからは、じゃあ具体的にVNIを与えるための処理を考えてみましょう。 例えば、Outerの共通部分をどこで準備するか、ingressで決めたVNIや処理内容を各egressへどう渡すかを考える必要があります。

この部分はいろんな実装が考えられますので、あくまで一例としてみてもらえればと思います。

プログラム間のデータと処理指示の受け渡し

各egressで呼ばれるプログラムには、書き換えに使うヘッダー情報と、実行する処理や引数を渡す必要があります。 このサンプルでは、共通ヘッダーを複製前にマップへ保存し、処理IDと引数を32バイトのdata_metaで引き継ぎます。

格納先 内容
data_metaの先頭16バイト 処理IDのprogramと検証用のmagicを各64ビットで保持します。
data_metaの後半16バイト vni、flags、inner_len、flow_hashを各32ビットで保持します。
header_cache Ethernet、IPv4、UDP、VXLANの共通テンプレートです。

ingressではPROGRAM_FORWARDで転送処理を進め、複製前にPROGRAM_REWRITEへ切り替えます。 egressは共通のディスパッチャーでコマンドの長さ、magic、処理IDを検証し、書き換えハンドラーへテールコールします。 コマンドが不正な場合やハンドラーが未登録の場合は、パケットを破棄します。

図を見てみましょう。複製時のパケット本体はInnerのままで、tunnel向けのコピーだけが、マップから取り出した50バイトのOuterを付ける事が想像できると思います。

%%{init: {"theme":"base","look":"classic","fontFamily":"DejaVu Sans, sans-serif","themeVariables":{"lineColor":"#666666","clusterBkg":"#fafafa","clusterBorder":"#aaaaaa","edgeLabelBackground":"#ffffff"},"flowchart":{"htmlLabels":false,"curve":"linear"},"themeCSS":".edgeLabel rect, .edgeLabel .background { fill: #ffffff !important; opacity: 1 !important; } .labelBkg { background-color: #ffffff !important; }"}}%%
flowchart TB
    accTitle: Shared Outer template and metadata handoff
    accDescr: A 1514-byte Inner frame stays unchanged while its shared 50-byte Outer template is saved in a Per-CPU LRU map. Devmap checks output MTUs and replicates the Inner frame with a 32-byte command. Access egress keeps the Inner frame. Tunnel egress retrieves or rebuilds the template, checks the final length, prepends Outer, and rewrites addresses.
    inner["Inner frame: 1514 B"] --> prepare["Ingress forwarding<br/>prepare shared Outer template"]
    prepare -. "store template" .-> cache[("Per-CPU LRU: header_cache<br/>key: (VNI, Inner length)<br/>Outer template: 50 B")]
    prepare -->|"32 B metadata<br/>REWRITE + arguments"| group["DEVMAP<br/>check MTU per output<br/>replicate Inner frame"]
    group -->|"access MTU: 1500"| access["Access egress<br/>Inner frame: 1514 B"]
    group -->|"tunnel MTU: 1600"| tunnel["Tunnel egress<br/>check final length<br/>prepend 50 B / rewrite"]
    cache -. "read / validate<br/>rebuild on miss" .-> tunnel
    tunnel --> output["Outer 50 B + Inner 1514 B<br/>frame: 1564 B<br/>Outer IP packet: 1550 B"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class prepare,access,tunnel process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class group,cache map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

devmapはegress実行前にMTUを検査するため、複製前にはOuterを付けません。 access向けはInnerの長さで検査し、tunnel向けはegressでOuterを含む最終長も検査します。 VXLAN_OVERHEADの50バイトは、Ethernet 14、IPv4 20、UDP 8、VXLAN 8バイトの合計です。

vxlan_rewrite()では、32バイトのコマンドを外し、先頭に50バイト確保してテンプレートをコピーします。 次の抜粋では、headerに取得して検証を済ませたテンプレートが入っています。

if (bpf_xdp_adjust_meta(ctx, sizeof(struct xdp_command)) ||
    bpf_xdp_adjust_head(ctx, -VXLAN_OVERHEAD))
  return XDP_DROP;
data = (void*)(long)ctx->data;
end = (void*)(long)ctx->data_end;
if (data + VXLAN_OVERHEAD > end) return XDP_DROP;
__builtin_memcpy(data, header.bytes, VXLAN_OVERHEAD);

VLANとVNIによるBUMの分離

ここまでは、対象のVNIが決まっているものとして複製先を選びました。 同じtrunkで複数のVLANを扱う場合は、その前に入力フレームが属するVNIを決める必要があります。 今回のVLAN対応ポートでは、入力ifindexとVIDの組からVNIを選び、そのVNIのdevmapへBUMを複製します。 例えば、一つのtrunkでVID 10をVNI 100へ、VID 20をVNI 200へ割り当てられます。 分類にはVIDだけでなく入力ifindexも使うため、別のポートのVID 10をVNI 300へ割り当てても、VNI 100の複製先とは混ざりません。

ポートごとの対応はvlansに設定します。 次の設定では、一つのtrunkで二つのVIDを受け入れます。 各VNIのグループには、このtrunkと必要な出力ポートを登録します。

{
  "device": "trunk0",
  "vlans": [
    {"vid": 10, "vni": 100},
    {"vid": 20, "vni": 200}
  ]
}

ingressでは、802.1Qタグを検証してVIDを取り出し、vlan_bindingsからVNIを取得します。 検索部分を抜き出すと、次のようになります。

struct vlan_key key = {.ifindex = ingress, .vid = vid};
__u32* binding = bpf_map_lookup_elem(&vlan_bindings, &key);
if (!binding) return XDP_DROP;
vni = *binding;

取得したVNIを使い、vni_groupsからdevmapを選びます。 分類したVNIはメタデータで引き継ぎ、VIDはInnerに残したタグからegressで読み直します。 このため、32バイトのコマンド領域を増やす必要はありません。

共有trunkへの出力では、VNIへの所属とInnerのVIDを組み合わせて検証します。 例えばVNI 100と200の両方に属するtrunkでも、VNI 100のコピーにはVID 10を要求します。 VNI 100のパケットにVID 20が入っていた場合は、そのtrunkへ出しません。 この検証には、port_vnisに登録したVNIと出力ifindexの組、および期待するVIDを使います。

VXLAN受信時はOuterを外して同じVNIのaccessへ送り、他のtunnelへは転送しないsplit horizonでループを防ぎます。 その際も、Innerに同じegress検証を適用します。 さらに、受信tunnelのifindexとVXLANのVNIが許可された組であることを、カプセル化解除前に確認します。 VNIがホスト全体で設定されていても、別のtunnelポートからそのVNIを受信できるとは限りません。

%%{init: {"theme":"base","look":"classic","fontFamily":"DejaVu Sans, sans-serif","themeVariables":{"lineColor":"#666666","clusterBkg":"#fafafa","clusterBorder":"#aaaaaa","edgeLabelBackground":"#ffffff"},"flowchart":{"htmlLabels":false,"curve":"linear"},"themeCSS":".edgeLabel rect, .edgeLabel .background { fill: #ffffff !important; opacity: 1 !important; } .labelBkg { background-color: #ffffff !important; }"}}%%
flowchart TB
    accTitle: VLAN-scoped BUM forwarding across VXLAN
    accDescr: A tagged frame on trunk0 selects VNI 100 for VID 10 or VNI 200 for VID 20. Each devmap sends local copies and a tunnel copy with its original inner tag. The remote VTEP checks tunnel admission, decapsulates, and validates output membership and the inner VID before sending to a shared trunk.
    input["trunk0: one 802.1Q frame<br/>Inner VID 10 or VID 20"] --> classify["vlan_bindings<br/>(ingress ifindex, VID) → VNI"]
    classify -->|VID 10| a["vni_groups[100]<br/>DEVMAP broadcast"]
    classify -->|VID 20| b["vni_groups[200]<br/>DEVMAP broadcast"]
    a --> local10["Local VID 10 output<br/>Inner unchanged"]
    b --> local20["Local VID 20 output<br/>Inner unchanged"]
    a --> tunnel10["Shared uplink<br/>Outer VNI 100 / Inner VID 10"]
    b --> tunnel20["Shared uplink<br/>Outer VNI 200 / Inner VID 20"]
    decap["Remote VTEP ingress<br/>check allowed tunnel / VNI<br/>then decapsulate"] --> policy["Remote egress: port_vnis<br/>(VNI, egress ifindex)<br/>require expected Inner VID"]
    policy -->|Match| output["Remote trunk<br/>Inner tag unchanged"]
    policy -->|Mismatch| drop["Drop this output copy"]
    tunnel10 --> decap
    tunnel20 --> decap
    class drop rejected;
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    classDef rejected fill:#ffffff,stroke:#666666,color:#222222,stroke-dasharray:4 3;
    class classify,decap,policy process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class a,b map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

分岐はVID 10と20の別々の入力フレームを表し、各フレームは一つのVNIを選びます。 tunnel向けにはInnerのタグを保持したコピーを送り、受信側は出力ポートのVNIとVIDを検証します。

この実装は、単一の802.1Qタグを保持したまま転送する構成に絞りました。 同じVNIに属するVLAN対応ポートには、同じVIDを設定します。 対向VTEPも、そのVIDを受け入れるように設定します。 タグの付け外しやVID変換は実装していません。 同じVNI内に、従来の固定VNIポートとVLAN対応ポートを混在させる設定も拒否します。 従来の固定VNIポートだけを使う設定では、Innerのタグをそのまま転送します。

VLAN対応ポートは、未登録VID、タグなし、VID 0と4095、途中で切れたタグ、802.1ad、二重タグを破棄します。 PCPとDEIは分類に使わず、タグのビットをそのまま保持します。 実NICのRX VLAN strippingでタグが取り除かれた場合も、そのフレームをタグなしとして破棄します。そのため、転送するには、strippingを無効にする必要があります。

UpdateMembers()では、当初設定したグループからメンバーを外したり、外したメンバーを戻したりできます。 この更新ではVLANの分類や受信許可は変わりません。VIDとVNIの対応を変える場合は、設定を再ロードします。

ちなみにですが、完全なJSON設定例と許可条件はVLAN対応の説明にまとめてたりしてます。(割と端折った)

ここまでの構成が実際に動くか、netnsとvethで確認してみましょう。

netnsでの動作確認

3つのVTEPと、VNI 100と200に属する端末をvethでつなぎ、このサンプルを動かしました。 Linux bridgeやLinuxのVXLANデバイスは使わず、カプセル化とカプセル化解除もXDPで行います。

以下のトポロジー図を見るとわかる通り、VTEPと端末をそれぞれ独立したnetnsへ置き、vethで接続しています。

%%{init: {"theme":"base","look":"classic","fontFamily":"DejaVu Sans, sans-serif","themeVariables":{"lineColor":"#666666","clusterBkg":"#fafafa","clusterBorder":"#aaaaaa","edgeLabelBackground":"#ffffff"},"flowchart":{"htmlLabels":false,"curve":"linear"},"themeCSS":".edgeLabel rect, .edgeLabel .background { fill: #ffffff !important; opacity: 1 !important; } .labelBkg { background-color: #ffffff !important; }"}}%%
flowchart LR
    accTitle: Three-VTEP VXLAN network namespace topology
    accDescr: VTEP A connects to VTEPs B and C through two direct veth underlay links. Each VTEP has separate VNI 100 and VNI 200 access endpoints, and A has one extra VNI 100 access endpoint. Every endpoint and VTEP has its own namespace.
    a100["a-100 namespace<br/>VNI 100"] ---|"eth0 / p0"| A["VTEP A namespace<br/>goxdp / XDP VXLAN"]
    a200["a-200 namespace<br/>VNI 200"] ---|"eth0 / p1"| A
    alocal["a-local namespace<br/>VNI 100"] ---|"eth0 / p4"| A
    A ---|"p2 / p2<br/>192.0.2.1 / 192.0.2.2<br/>VXLAN over veth<br/>MTU 1600"| B["VTEP B namespace<br/>goxdp / XDP VXLAN"]
    A ---|"p3 / p2<br/>192.0.3.1 / 192.0.3.2<br/>VXLAN over veth<br/>MTU 1600"| C["VTEP C namespace<br/>goxdp / XDP VXLAN"]
    B ---|"p0 / eth0"| b100["b-100 namespace<br/>VNI 100"]
    B ---|"p1 / eth0"| b200["b-200 namespace<br/>VNI 200"]
    C ---|"p0 / eth0"| c100["c-100 namespace<br/>VNI 100"]
    C ---|"p1 / eth0"| c200["c-200 namespace<br/>VNI 200"]
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class A,B,C process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;

VNIごとのBUM配信と、VXLANで対向VTEPの端末まで配送できることを確認しました。 確認環境はLinux 7.0.0-38-genericとvethで、テストの詳細と実行手順はtesting.mdにまとめています。

このように XDPでも BUMがサポートできてそうな事がわかりました。やったね!

動作を確認できたので、次はTC併用版との性能差を見てみましょう。

TC併用版との性能比較

同じ転送設定で--backend tcへ切り替え、既定の--backend xdpと比較しました。 TC併用版では、検証とカプセル化解除をXDPで行い、XDP_PASSでskbへ渡してからTCで複製します。

access向けを先に送り、tunnel向けにはOuterを一度付けて宛先ごとに書き換えます。VLANからVNIへの分類と、VNIやVIDの検証の処理は、XDP版と共通の仕組みを使ってます。

%%{init: {"theme":"base","look":"classic","fontFamily":"DejaVu Sans, sans-serif","themeVariables":{"lineColor":"#666666","clusterBkg":"#fafafa","clusterBorder":"#aaaaaa","edgeLabelBackground":"#ffffff"},"flowchart":{"htmlLabels":false,"curve":"linear"},"themeCSS":".edgeLabel rect, .edgeLabel .background { fill: #ffffff !important; opacity: 1 !important; } .labelBkg { background-color: #ffffff !important; }"}}%%
flowchart TB
    accTitle: XDP and XDP plus TC VXLAN replication paths
    accDescr: Both backends classify and decapsulate in XDP. The XDP backend replicates through a devmap and rewrites each tunnel copy in an egress program. The TC backend passes an skb to TC, sends access copies first, prepends Outer once, and rewrites each tunnel destination. Both preserve the Inner frame.
    subgraph xdp["XDP backend"]
        direction TB
        xi["Ingress XDP<br/>validate / decap"] --> group["DEVMAP broadcast"]
        group --> rewrite["Per-copy egress XDP<br/>attach Outer / rewrite"]
        rewrite --> xo["Tunnel copies<br/>same Inner / varied Outer"]
    end
    subgraph tc["XDP + TC backend"]
        direction TB
        ti["Ingress XDP<br/>validate / decap"] --> pass["XDP_PASS<br/>create skb"]
        pass --> clone["TC ingress<br/>access copies first<br/>prepend Outer once"]
        clone --> target["Rewrite each destination<br/>N-1 clones + redirect"]
        target --> tout["Tunnel copies<br/>same Inner / varied Outer"]
    end
    classDef default fill:#ffffff,stroke:#666666,color:#222222;
    class xi,rewrite,ti,pass,clone,target process;
    classDef process fill:#edf3fa,stroke:#74849a,color:#222222;
    class group map;
    classDef map fill:#edf4ee,stroke:#7b9180,color:#222222;

図のフローで示した通り、XDP版はdevmapで複製してから各egressで加工し、TC併用版はTC ingressで書き換えと複製を行います。

このveth環境では、XDP版はTC併用版の約1.6〜1.8倍の受信合計スループットを達成しました。 XDPerfの4ワーカーと4キューのvethを使い、一つのVNIの64個のUDPフローを2個のunicast VTEPへ複製しました。 表は各3回の受信合計の中央値で、VLAN対応を追加する前のバイナリでの測定結果です。

入力フレーム長 XDP(Mpps) XDP + TC(Mpps) XDP / TC
64バイト 1.861 1.056 1.76倍
1514バイト 1.454 0.896 1.62倍

この値は、同じKVMホストで送信器、転送処理、受信側を動かしたときの処理量です。 実NICでの性能や無損失転送の上限、未測定のXDP_CLONEとの性能差を示すものではありません。 測定条件と生データは測定レポートにまとめました。

終わりに

今回の記事では既存のXDPでも、devmap broadcastとegress programを組み合わせれば、BUMを複製し、同じInnerを異なるOuterで送れることを示しました。

論文ではコピーを個別に書き換えられないと説明していますが、devmap egress programを使えば、既存のXDPでも実現できます。

一方、XDP_CLONEには、コピー番号を直接扱えることや原本を直接スタックへ渡せることなど、既存の構成より便利な点もありそうです。 性能や使い勝手でどんな差が出るのか、今後の比較に期待しています。

ちなみにLinkedinに流してみるかと言う事でLLMに翻訳してもらった英語版はこちら。 takeio.hatenablog.com

Go Conference 2026で発表とスタッフをやってました

Why

やったことや思ったことを忘れる前に、記事にしておこうと思います。

※なお、この記事は所属企業や所属団体を代表するものではなく、筆者個人の意見です。

What

gocon2026のパネル

去年に引き続き、Go Conference 2026で登壇してきました。今年は40分枠で応募し、採択していただきました。

takeio.hatenablog.com

今回も大変高い倍率の中で採択していただき、嬉しく思います!

発表内容について

When Goroutines Are Not Enough: Runtime Locality in High-Throughput Go というタイトルで登壇しました。

発表内容を3行でまとめると、こんな感じです。

  • Goroutineは並行性を表す単位だけど、実行場所やローカリティを保証する単位ではない。
  • では、CPU配置の最適化という観点では、どんなことが起きるのか?
  • 自作のパケットキャプチャツールを題材に見ていこう!

という内容で話しました。

事前の練習では普通に話すと40分を超えていたので、時間内に収まるかなと不安になり、当日はだいぶ早口になってしまいました。そこは反省点ですが、少しでも面白がってもらえていたら嬉しいです。

当日は立ち見も出ていて、たくさんの方に聞いてもらえてよかったなと思いました。有意義な時間にできていたら嬉しいです。

スライドは以下の通りです。良ければスターとかしてくれると嬉しいです!

speakerdeck.com

スタッフ業をしてみた感想

参加の背景

自分はこの4年間*1、登壇する側ばかりをやってきました。

例えば、有名どころをいくつか挙げると、以下のようなイベントで登壇してきました。どれもCFPを出して高い倍率の中で採択されるか、招待してもらう形で登壇するイベントです。

  • Go Conference
  • YAPC
  • クラウドネイティブデイズ
  • PyCon APAC
  • JANOG LT × 2
  • KubeCon Community Day × 2
  • eBPF Japan Meetup

また、今年度は以下のイベントで話す予定です。

  • Go Conference:登壇済み
  • Kotlin Fest:登壇予定
  • eBPF Workshop:登壇予定

こうして見ると、登壇に関しては、エンジニアの中でもそこそこ経験を積ませていただいたのではないかと思っています。

一方で、一昨年からはeBPF Japan Meetupの共同オーガナイザーもやっています。テーマを決めて登壇者を調整したり、会場を借りたり、懇親会を準備したりと、裏方というか、プロデューサーやディレクターに近い仕事をしています。参加者は多くても30〜50人ぐらいのイベントです。

ebpf.connpass.com

こうした経験を通じて、技術イベントはどうやって作られていくのだろう、どうやって熱量を維持しながら登壇者を選んでいくのだろう、と考えるようになりました。どんな基準で良い発表者を選ぶのか、登壇する側はどうやって選ばれるのかも気になっていました。

そこで、大きなイベントのスタッフをやって学びたいと思い、今回はスタッフとしても参加しました。

やったこと

自分が関わったのは、CFPのレビュー、Go本家のカンファレンスページの掲載作業、スピーカーガイドの作成、当日のスポンサー対応です。

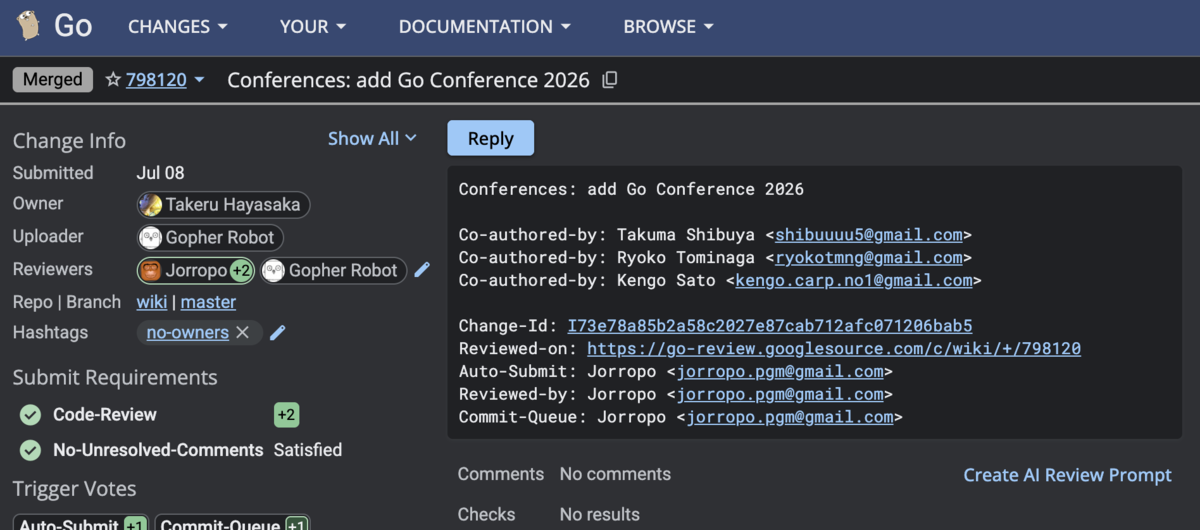
特に掲載作業は面白い経験で、このようにGo本家のWikiにはカンファレンスページがあります

go.dev

ここに載せるためには、パッチを出す必要があり、初めてのGoリポジトリへの投稿しました。 https://go-review.googlesource.com/c/wiki/+/798120 

go本体のwikiにパッチ投稿した様子。参加した人みんなでco-authered-byしてみた。

Goへの貢献の流れはこういう感じなんだなぁーと同じgerritなのでVPPにパッチ出した時を思い出してました。

さて、参加のタイミングから、自分が一番やりたかったのは、CFPのレビューとディスカッションを通じて、採択する発表が決まるまでのプロセスを見ることでした。審査基準の目線合わせから参加し、なるべく議論にも加わりながら、175件のうち自分の投稿を除く174件にレビューコメントを付けました。

自分の投稿を除いているのは、レビュアーもCFPに応募できたためです。自分の投稿にはレビューコメントや点数を付けず、なるべく公平になるよう、投稿内容にも自分だと分かる情報を書かないようにしました。いわゆるブラインド方式でレビューされるよう心がけた形です。

ただ、採択が決まるまでは本当にどきどきしました。オンラインでなければ、顔や反応で自分の投稿だとばれてしまいそうなぐらい、心臓に悪かったです。

レビュアーをするなら、自分も応募して審査中ずっとどきどきするのでやめた方がいいです。大変つらい....😇(精神衛生上悪い)

細かい意思決定の是非については差し控えますが、レビューは本当に真剣に行いました。全部読んだので決めましょう、というものではなく、何度もラウンドを重ねて、自信を持って選んだと言えるCFPを採択することを目指しました。夜遅くまでやっていたので、大変でした。

これを読んでいる方の中にも、CFPを出して採択されなかった方がいるかもしれません。採択は、さまざまな意見や力学の中で決まっています。自分が良いと思ったCFPでも採択されなかったものは多く、本当に運の部分も大きいと思います。luccafortさんが良いことを言っていたので、貼っておきます。

一方で、通りやすいCFPは確かにあり、コツというかセンスが関わる部分もあると確信しました。せっかくなので、知見を共有したいと思います。 noteだったら有料で売れる気もしています。冗談です

CFPを練るにあたっての所感と良いCFPとは

正直、今回はCFPを出すにあたって、特別な戦略を立てたわけではありません。ただ、昨年のブログで書いたポイントは押さえました。

  • 明瞭さ:平易な文章で短くまとめる
  • インパクト:聴講者が持ち帰れる内容を明示する
  • 適時性:なぜ今話すのかを事実とともに書く
  • 実現性:目安となるタイムテーブルを提示する

今年のプログラムは、昨年や一昨年と比べると、やや傾向が変わったように感じます。

以前は、以下のような発表が通っていました。

  • Goの新しい標準ライブラリや機能を主軸に話す
  • よく使われるライブラリを深く掘り下げる

一方、今年はユースケースや、これまであまり語られていなかったところに光を当てる発表が増えた気がします。そういう発表も拾いたいという話があったのは事実ですが、最終的に採択されたCFPを見ると、それだけが選考の主軸だったわけではないと思っています。ちゃんとキラッと光るものがありました。

自分が思うに、良いCFPには、「高い技術的インパクトがありつつ、聴講者に何を持ち帰ってもらえるのか」が書かれています。 もちろん、これだけで決まるわけではありません。ただ、ここを押さえたCFPは評価の上位に来ると思っています。これはこれだけ多くのCFPを読み、自分自身もいろいろなCFPを通してきた経験から、確信を持って言えます。

例えば、登壇に慣れていそうなgoccyさんやymotongpooさんのCFPを見ると、以下のような点が押さえられていると感じます。

  • ワクワクする内容か? 面白い技術トピックや、共感できる話があるか。
  • なぜその人が話すべきなのか? その人ならではの知見や試行錯誤、その分野での長年の経験があるか。
  • なぜコミュニティが聞くべきなのか? 今の技術的な潮流や、Goで次に注目されそうな話題とつながっているか。

このように、通っているCFPは、どれも推薦したくなるポイントがはっきり見えます。更に少数の尖った発表であっても、"N=1"な、所謂お前だけちゃう?という話ではなくちゃんと知見の形になってるように見えます。あとこのイベントはGoに関係する事であると言う主張が求められるのでそこを抑える必要がある独特なポイントがあります

(細かく見れば類型に整理できると思いますが、長くなるので、それはまたの機会にします...)

もう一点、CFPを推敲するコツを書き残しておきます。自分がこのイベントのオーガナイザーだったら、どんな発表を採択したいかを考えてみると、見えてくるものがあると思います。

例えば、こんなことを考えてみます。

  • この内容で、ちゃんと現地で登壇できるのかな?
  • 地方のイベントならぜひ聞きたいけど、年次カンファレンスの限られた発表枠を使ってでも採択したいかな?
  • 生成AIにありがちな言い回しが多く、適当に書いたように見えないかな? 余分な言葉が多くて、読み手は読みづらくないかな?

これは、小さなイベントでも大きなイベントでも共通する考え方だと思います。上司に良い評価をしてもらうにはどうすればいいのか、と相手の立場から逆算する感覚に近いですね。この観点で見直してみると、採択に近づくのではないかと思います。

ただ、何度も言いますが、CFPを通すにはセンスと運の両方が必要です。仮に通らなかったとしても、仕方ないです。全部のCFPがレイダーグラフ(HxHの6能力みたいなアレです)の全部をいい感じに埋めれてることはないので最後は運の問題なのです。

なので、そこは切り分けてイベント自体を楽しむのがおすすめです。

他の発表たちの見てた感想

今年、一番期待していたのは、goccyさんのGo における FFI のこれまでとこれからでした。期待を裏切らない、良い発表でした。

gocon.jp

発表では、線形メモリをmmapで確保することで、サンドボックス特性を保っているという話がありました。WasmからGoに変換するときに手を入れなければ、確かに保たれるのでしょうし、元のWasmのABIをうまく使っていて、なるほどなと思いました。

一方で、システムコールやファイルアクセスの制御などは、まだ未解決のように聞こえたので、そのあたりは今後の研究の余地があるところかなと思いました。自分もgoccyさんのwasm2goに着想を得た、似たようなツールを作っているので、公開したらどこかで発表したいと思っています。

20260914 0800 追記

ご本人からコメントを貰い誤解が解けました。詳しくはコメントを参照。だいたいできない事がないという状態でスゲーとなりました!

今回はスタッフ業務があり、発表は一つしか見られませんでした。資料が徐々に公開されているので、後からゆっくり見てみようと思います。

終わりに

スタッフ参加して、運営の方々がボランティアで多大な労力をかけていることには大変頭が下がる思いでした。

この記事を書きながら思い出したのですが、最初にスタッフへ応募したときは、機会があればNOCにも関われたら、などといろいろ考えていました。ただ、本業や大学院などで忙しく、思ってたよりも本当にわずかな貢献になってしまいました。

そもそも、初対面の人に挨拶するのは自分は得意ではないな、と改めて思い出したりもしました。人とのコミュニケーションが苦手だと、こういうときにつらいです...😇

ということで、スポットでの参加ばかりで、タイミーさんのような自分を受け入れてくださったGo Conferenceのスタッフの皆様に感謝しています。

また、資料作りに多大な貢献をしてくれた妻にも感謝しています。本当に、彼女のマサカリ等がなければ資料が成り立っていなかったかもしれません。

そして、レビューしてくれた同僚の皆さん、特に直前の依頼にもかかわらず、いろいろとレビューしてくれた@masu-miパイセンにも感謝を伝えて、この記事を締めくくりたいと思います。

*1:現職が10月で4年目終わりなのである

sudoもrebootも効かないLinuxサーバをなんとか再起動する時のメモ

概要

色々ドライバを弄っていたところ、カーネルの共有ワークキューである events_unbound が長時間ブロックされ、そのワーク項目が RTNL を保持したまま離さない状況に陥りました。 具体的には後続のカーネル処理がワークキュー上で滞留し、D state のプロセスが連鎖的に累積しました。

大変残念なことに、D state は割り込み不可の I/O 待ち状態のため kill -9 でも終了させられません。sudo も sudo reboot も応答せず、IPMI にも触れない状態に追い込まれました。

最終的に、生きていた rootを持ってる Docker コンテナに docker exec で入り、コンテナ内から /proc/sysrq-trigger を叩いてカーネルに強制リブートさせることで復旧できました。覚えておくと役に立つので書き残しておこうと思いました。

なぜsudoまで死ぬのか

events_unbound はカーネル全体で広く使われる共有ワークキューです。ここに乗ったワーク項目が長時間ブロックされると、後続のワーク項目はすべて滞留します。さらにそのブロック中のワーク項目が RTNL のようなグローバルロックを保持していると、ロックを必要とするカーネルパスもまとめて D state に落ちます。

つまりカーネル内の作業ディスパッチが事実上止まった状態です。ここまでなら被害は局所的に見えますが、現代の Linux はサービス間結合しているため、連鎖的に壊れます...

systemd-logind は netdev 状態を rtnetlink で監視しており、関連処理がブロックされます。PAM の pam_systemd.so は DBus 経由で logind の CreateSession を呼びますが、応答待ちで停止します。結果として新規 sudo や新規 SSH ログインが PAM の open_session で詰まります。sudo reboot も systemd 経由で graceful に落とそうとして hung task 待ちで死にます。

つまり root すら取れず、reboot も呼べない状態に陥ります。

通常のSysRqが効かない理由

こうした状況の定石は Magic SysRq です。

echo 1 | sudo tee /proc/sys/kernel/sysrq
echo b | sudo tee /proc/sysrq-trigger

これはカーネルの emergency_restart を直接叩くパスで、sudo reboot が詰まる原因を回避できます。本来こうした状況のための機能です。

しかし sudo 自体が PAM で詰まると、このコマンドも実行できません。IPMI などの out-of-band が使えない場合、ここで完全に詰みます。

Dockerコンテナ経由で抜け道を作る

成立条件は、コンテナが privileged または CAP_SYS_ADMIN を持っていること、kernel.sysrq がリブートを許可していること、ユーザが docker グループに入っているか docker.sock にアクセスできることです。

で、、、Docker デーモンは PAM や systemd-logind に依存せず動作します。docker exec は新規プロセスを既存コンテナの既存 cgroup に setns で投入するだけで動くため、詰まっているパスを一切経由しません。

まず何が使えるかを調べます。

ps -ef | grep -E 'tmux|screen|root' | grep -v grep

docker コマンドが使えるか確認します。

docker ps

これが通ればほぼ勝ちです。docker グループに入っているか、/var/run/docker.sock にアクセス権があれば通ります。

次に privileged なコンテナを選びます。datapath やネットワークを触るコンテナは、たいてい --privileged または --cap-add=NET_ADMIN,SYS_ADMIN で動作しています。そのコンテナに root shell で入ります。

docker exec -u root -it <container_id> /bin/bash

コンテナ内で SysRq が叩けるか確認します。

ls -la /proc/sysrq-trigger
cat /proc/sys/kernel/sysrq
cat /proc/self/status | grep CapEff

/proc/sysrq-trigger が writable で、kernel.sysrq の値にリブートを許可する 128 ビットが立っていれば叩けます。Ubuntu のデフォルトは 176 でこれを含むため問題ありません。

最後に発火させます。

echo s > /proc/sysrq-trigger
echo u > /proc/sysrq-trigger
echo b > /proc/sysrq-trigger

s, u, b はそれぞれ独立した SysRq コマンドです。

s と u はそれぞれ別の種類のデータロスを防ぐ予防策です。 s (sync) はカーネルのページキャッシュにあるダーティページをディスクに書き戻します。Linux はファイル書き込みを即座にディスクへ反映するのではなく、一度メモリ上のページキャッシュに置いて遅延ライトする設計です。通常は数秒から数十秒の間隔で writeback されますが、その間に強制リブートされると、まだディスクに到達していない書き込みは失われます。s を叩くと未書き戻しのページが flush されます。

u (remount RO) はマウント中のファイルシステムを read-only に切り替えます。read-only 化の過程でジャーナルの最終 flush と consistent state の確定が行われ、ファイルシステムメタデータが clean な状態でリブートを迎えられます。

ただし注意点として、今回のような wedge 状況では s や u 自体もハングする可能性があります。s はカーネルの writeback path に依存し、u も filesystem layer に依存するため、関連サブシステムが詰まっていると返ってきません。それでも先に投げる理由は、効けば予防になり、効かなくても b は独立に発火するため害がないからです。

b は emergency_restart 経由でハードウェアリセット相当の再起動を即座に発火させます。

s と u が応答を返さなくても b には影響しません。b はファイルシステムや他のサブシステムに依存せず、ほぼ即座にハードウェアレベルのリセットを呼び出すパスだからです。ファイルシステム周辺が詰まっている状況では s や u の完了は期待できませんが、それでも b は必ず効きます。

カーネルが再起動した瞬間に SSH 接続は途絶えます。クライアント側からは TCP コネクションが切断される形で見えます。SSH が切れたら成功ですね(多分!)

なぜこれが効くのか

通常の sudo や新規 SSH は PAM stack を経由しますが、docker exec は経由しません。systemd-logind の CreateSession も呼ばず、新規 cgroup も作成せず、既存 cgroup に setns で入るだけです。

privileged コンテナ内の /proc/sysrq-trigger はホストカーネルのものを参照します。sysrq の発火パスは IRQ context レベルで動作するため、userspace daemon の死活に依存しません。ホスト側の logind や systemd が死んでいても効きます。

まとめ

sudo が効かない状態は、sudo 自体の問題ではなく、依存先となる logind や systemd、PAM が死ぬことが理由でした。さらに遡るとカーネルのワークキュー停止とグローバルロック保持が根本原因になっていることがあります。Docker デーモンはこうした状況において、独立した特権付き実行パスとして機能します。普段は使わないパスですが、頭の片隅に置いておくと役に立ちます。(実際役立って助かった・・・)

BPF tail call 先のプログラムで fentry/fexit が発火しない問題と、それに対するカーネルパッチの設計してみた。

はじめに

XDP のパケットキャプチャツール xdp-ninja というものを開発しています。そこである問題にぶつかりました。

xdp-ninja は、既存の XDP プログラムに fentry/fexit トランポリンをアタッチして、パケットを非侵入的にキャプチャするツールです。対象の XDP プログラムを書き換える必要がなく、tcpdump のように手軽に使えることを目指しています。それでいて対象のパケットだけを吸い上げる構造になっているので、既存の XDP プログラムで処理されるべき通信への影響をなるべく小さくすることができます。

次のようにワンライナーでインストールできます。

curl -fsSL https://raw.githubusercontent.com/takehaya/xdp-ninja/main/scripts/install.sh | sudo bash

使い方もシンプルです。

# XDP プログラムが動いているインターフェースのパケットをキャプチャ
sudo xdp-ninja -i eth0 --mode exit | tcpdump -n -r -

# フィルタ付き
sudo xdp-ninja -i eth0 "host 10.0.0.1 and tcp port 80" | tcpdump -n -r -

# pcap ファイルに書き出し
sudo xdp-ninja -i eth0 -w capture.pcap -c 100

詳しくは xdp-ninja の README をご覧ください。

さて、開発を進めていく中で、単体の XDP プログラムに対しては問題なく動作するのですが、bpf_tail_call を使ったプログラム構成で問題が発生しました。

このブログは、その対処法を検討して色々とサーベイしたので備忘録的に残すものです。

tail call を使った XDP の構成

実運用の XDP プログラムでは、処理の段階ごとにプログラムを分割し、bpf_tail_call でつなぐ構成が広く使われています。

[Program_A: ingress] --tail_call--> [Program_B: process] --tail_call--> [Program_C: egress]

各段階が独立した BPF プログラムとして実装され、prog_array を介した tail call で次の段階に制御を渡します。

この構成で、例えば process や egress の段階に fentry をアタッチしてパケットをキャプチャしたい、というのは自然な発想です。しかし xdp-ninja で実際に試してみると、tail call 先のプログラムにアタッチしたにもかかわらず 1 パケットもキャプチャできないという現象が起きました。

先頭の Program_A にアタッチすればパケット自体は取れます。しかし、本当に見たいのは tail call 先の Program_B や Program_C の動作です。例えば Program_C が XDP_PASS を返したのか XDP_DROP を返したのかを知りたい場合、fexit を Program_C にアタッチする必要があります。それが動きません。

この原因を追っていくと、BPF JIT の設計レベルの制約にたどり着きました。

fentry/fexit の仕組み

まず fentry/fexit がどう動くかを整理します。

fentry/fexit は BPF trampoline を利用したトレーシング機構です。BPF プログラムの先頭にある NOP 命令を call 命令にパッチすることで、プログラムの入口である fentry と出口である fexit にフックを挿入します。

実際のカーネルコードを見てみます。x86_64 の BPF JIT が各プログラムの先頭に生成するプロローグは arch/x86/net/bpf_jit_comp.c の emit_prologue() で定義されています。

static void emit_prologue(u8 **pprog, u8 *ip, u32 stack_depth, bool ebpf_from_cbpf,
                          bool tail_call_reachable, bool is_subprog,
                          bool is_exception_cb)
{
    u8 *prog = *pprog;

    emit_cfi(&prog, ip, ...);

    /* BPF trampoline can be made to work without these nops,
     * but let's waste 5 bytes for now and optimize later
     */
    emit_nops(&prog, X86_PATCH_SIZE);    // ← 5-byte NOP: fentry/fexit のパッチポイント

    if (!ebpf_from_cbpf) {
        if (tail_call_reachable && !is_subprog)
            EMIT3(0x48, 0x31, 0xC0);     /* xor rax, rax (tail call counter 初期化) */
        else
            emit_nops(&prog, 3);
    }

    EMIT1(0x55);                          /* push rbp */
    EMIT3(0x48, 0x89, 0xE5);             /* mov rbp, rsp */

    /* ---- X86_TAIL_CALL_OFFSET ここから ---- */
    EMIT_ENDBR();                         /* tail call はここに着地する */

    if (stack_depth)
        EMIT3_off32(0x48, 0x81, 0xEC, round_up(stack_depth, 8));  /* sub rsp, N */
    // ...
}

この結果、JIT 出力は以下のメモリレイアウトになります。

+0:  ENDBR64
+4:  NOP (5B)          ← fentry パッチポイント
+9:  xor eax, eax      ← tail call counter 初期化
+12: push rbp
+13: mov rbp, rsp
+16: ENDBR64            ← tail call のランディングポイント (X86_TAIL_CALL_OFFSET)
+20: sub rsp, N
     ... プログラム本体 ...

ここで重要なのは、+4 の NOP はプログラムロード時には何もしない命令だということです。fentry/fexit がアタッチされると、カーネルの trampoline コードである kernel/bpf/trampoline.c が、実行時にこの NOP を CALL 命令に書き換えます。これがライブパッチングの仕組みです。

// kernel/bpf/trampoline.c - bpf_trampoline_update_fentry()
// NOP → CALL にライブパッチする
bpf_arch_text_poke(ip, BPF_MOD_NOP, BPF_MOD_CALL, NULL, trampoline_image);

bpf_arch_text_poke() は arch/x86/net/bpf_jit_comp.c で実装されており、smp_text_poke_single() を使ってアトミックに 5 バイトを書き換えます。fentry アタッチの前後で、メモリ上の命令は次のように変化します。

アタッチ前: +4: 0F 1F 44 00 00      (5-byte NOP)
アタッチ後: +4: E8 xx xx xx xx      (CALL <trampoline>)

つまり、すべての BPF プログラムはロード時にフック可能な NOP を先頭に埋め込んでおき、fentry/fexit が要求された時点で動的にパッチされるという仕組みです。

fexit の仕組み

fentry がプログラムの入口をフックするのに対して、fexit は出口をフックします。BPF JIT はプログラムの共通エピローグ、すなわち emit_return 付近でも同様の仕組みを使っています。

fexit がアタッチされると、trampoline は fentry 側の CALL で入口を記録し、プログラムが return した後に fexit 側のコールバックを呼び出します。具体的には BPF_TRAMP_F_CALL_ORIG フラグが設定され、trampoline が以下の流れを実行します。

  1. fentry コールバックを実行する
  2. 元のプログラム本体を CALL して戻ってくる
  3. fexit コールバックを実行し、戻り値を引数として受け取る

fentry と fexit はペアで動作し、fentry 側で設定した RCU ロックやコンテキストを fexit 側で解放します。つまり fentry が発火しなければ fexit も発火しません。

tail call で発火しない理由

原因は、tail call がプロローグをスキップする設計になっていることです。

tail call は通常の関数呼び出しとは異なり、呼び出し元のスタックフレームを再利用します。JIT が tail call のジャンプコードを生成する emit_bpf_tail_call_indirect() を見ると、ジャンプ先が明示的にオフセットされていることがわかります。

// arch/x86/net/bpf_jit_comp.c - emit_bpf_tail_call_indirect()

/* goto *(prog->bpf_func + X86_TAIL_CALL_OFFSET); */
EMIT4(0x48, 0x8B, 0x49,                           /* mov rcx, [rcx + 32] */
      offsetof(struct bpf_prog, bpf_func));
EMIT4(0x48, 0x83, 0xC1,                           /* add rcx, X86_TAIL_CALL_OFFSET */
      X86_TAIL_CALL_OFFSET);
emit_indirect_jump(&prog, BPF_REG_4, ...);

X86_TAIL_CALL_OFFSET は 12 + ENDBR_INSN_SIZE で、プロローグの ENDBR の位置を指しています。つまり tail call は +0 ではなく +16 の ENDBR64 の位置にジャンプします。その結果、以下のことが起こります。

  1. +4 の fentry NOP を完全にバイパスする
  2. プロローグの push rbp / mov rbp, rsp を実行しない
  3. tail call counter は rax レジスタ経由で引き継がれる
通常:
+0 ENDBR → +4 NOP(fentry) → +9 xor rax → push/mov rbp → +16 ENDBR → +20 sub rsp → 本体
            ^^^^^^^^^^^^^^
            ここを通る(fentry 発火)

tail call:
+16 ENDBR → +20 sub rsp → 本体
^^^^^^^^^^
ここに直接着地して +4 を通らない

おそらくこのスキップは意図的な最適化です。例えば、100GbE 環境では 1 パケットあたり 67ns の処理バジェットしかなく、プロローグの省略で約 30ns を節約しています。パフォーマンス上の理由で、あえてこうなっているのだと思っています。

カーネルパッチの設計

ここからは、この問題を解決するためのカーネルパッチの設計について述べます。2026 年 3 月時点で、tail call 先への fentry/fexit を実現するパッチはまだ存在しません。以下は自分が検討している設計です。

fentry 向けの設計: tail call ランディング後に NOP を追加する

最もシンプルな解決策は、tail call のランディングポイント直後にもう一つ NOP を配置することです。

+0:  ENDBR64
+4:  NOP (5B)          ← 既存の fentry パッチポイント
+9:  xor eax, eax
+11: push rbp
+12: mov rbp, rsp
+15: ENDBR64            ← tail call ランディング
+20: NOP (5B)           ← 新規: tail call 用 fentry パッチポイント
+25: sub rsp, N
     ... プログラム本体 ...

ただし、通常の呼び出しでは +4 と +20 の両方を通過するため、何も対策しなければ fentry が 2 回発火してしまいます。これを防ぐため、fentry アタッチ時には +20 のみをパッチし、+4 はパッチしないという方針にします。

通常:
+0 ENDBR → +4 NOP(未パッチ) → ... → +20 CALL tramp → 本体
            ^^^^^^^^^^^^^^           ^^^^^^^^^^^^^^
            パッチしない             ここだけパッチ

tail call:
+15 ENDBR → +20 CALL tramp → 本体
             ^^^^^^^^^^^^^^
             ここだけパッチ

どちらの経路でも +20 の 1 箇所だけを通るため、fentry は 1 回だけ発火します。

具体的な修正としては、パッチは最小限の 2 コミットで構成できると考えています。

  1. arch/x86/net/bpf_jit_comp.c の emit_prologue() に NOP を追加する
  2. kernel/bpf/trampoline.c で tail call 用 NOP をパッチする処理を追加する

fexit 向けの設計: 2 つの発火ポイントを設ける

fexit は fentry より複雑です。tail call では制御が戻らないため、出口が 2 箇所存在します。

  1. 通常の exit として、プログラムが return する時点のエピローグ
  2. tail call 直前として、プログラムが次の tail call を実行する直前
プログラム本体
  |
  +--→ tail call する場合:   NOP(fexit) → bpf_tail_call() → 次のプログラムへ
  |                          ^^^^^^^^^^
  |                          ここで fexit 発火
  |
  +--→ return する場合:      NOP(fexit) → leave; ret → 呼び出し元へ
                             ^^^^^^^^^^
                             ここで fexit 発火

通常の return ではエピローグの NOP が発火し、tail call 成功時は pre-tail-call の NOP が発火します。tail call が成功すれば制御は戻らず、失敗すれば fallthrough してエピローグに到達するため、二重発火は起きないのではないかと考えています。

POC パッチの実装とメーリングリストでの議論

fexit は複雑なため、まず fentry だけでも動くように POC パッチを書いてみました。ブランチは takehaya/linux:tailcall-fentry-poc で公開しています。

パッチは 2 コミットで構成されています。

  • bpf, x86: patch tail-call fentry slot on non-IBT JITs -- x86 JIT の tail call ランディング位置にある NOP スロットを fentry 用にパッチする処理を追加しています。IBT の有無で ENDBR の配置が異なるため、ランディングアドレスを基準にしてレイアウトを判定するようにしています。
  • selftests/bpf: cover fentry on tailcalled programs -- tail call 経由の fentry 発火を検証するセルフテストを追加しています。直接呼び出しと tail call 経由の両方で fentry が 1 回だけ発火することを確認しています。

このパッチを linux-kernel メーリングリスト に投稿しました。tail call 先の leaf プログラムが fentry ベースのデバッグにおいて死角になっている点を説明し、観測可能にしたいという動機を伝えました。(メーリスに慣れてないのでやり取りが拙いのは堪忍してください... :innocent: )

しかし、メンテナの Alexei Starovoitov 氏からは以下のような返答がありました。

I get that, but I'd rather not open this can of worms. We had enough headaches when tailcalls, fentry, subprogs are combined.

過去に tail call と fentry とサブプログラムの組み合わせで多くの問題が発生したパッチセットを引き合いに出し、これ以上この領域を複雑にしたくないという判断でした。

結果としてこのパッチは却下となりました。カーネル側での解決が当面見込めないため、xdp-ninja 側で回避策を講じる必要があります。

xdp-ninja での回避策

カーネルパッチによる解決が難しいことがわかったため、xdp-ninja 側では以下のアプローチを検討しています。

現状の xdp-ninja でも、tail call チェーンの先頭である Program_A に fentry/fexit をアタッチすればパケット自体はキャプチャできます。しかし tail call 先の Program_B や Program_C はキャプチャできません。

そこで --wrap モードというものを考えています。prog_array の値を一時的に wrapper プログラムに書き換え、tail call 先のプログラムの前にキャプチャ処理を挟む方式です。

通常:    [Program_A] --tail_call--> [Program_B]
--wrap:  [Program_A] --tail_call--> [wrapper: キャプチャ] --tail_call--> [Program_B]

カーネル側の変更は不要で、ユーザ空間だけで実現できます。ただし entry 相当のキャプチャしかできず、exit として action を取得することはできないという制約があります。

おわりに

xdp-ninja を開発する中で、fentry/fexit と tail call の組み合わせが動かないという問題を踏み抜き、BPF JIT のプロローグスキップという設計上の制約に行き当たりました。カーネルパッチを書いて提出しましたが、tail call と fentry の組み合わせが過去に多くの問題を引き起こしてきた経緯から、メンテナの判断で却下されました。

この問題は xdp-ninja に限らず、BPF のトレーシングや観測ツール全般に影響します。tail call を使った XDP プログラムが増えている中で、tail call 先の leaf プログラムが観測の死角になっているのは悩ましい状況です。

カーネル側での解決が当面難しいため、xdp-ninja としては --wrap モードのようなユーザ空間側の回避策を実装していく方針で検討しています。 もし何か知ってる人がいたらぜひ教えてください。

XDPベースなTraffic Generator: XDPerfの紹介

はじめに

この記事はBBSakuraNetworksアドベントカレンダー2025の24日目の記事です。

皆さんこんにちは。takemioIOです。 今年も会社のアドベントカレンダーに参加しています。

今回取り上げる内容は、所属企業とは無関係に個人で開発した XDPerf という高性能トラフィックジェネレーターについてです。所属に関係しないため、自分のブログで書いてお送りしようと思います。

github.com

XDPerfのロゴ

このツールの説明

XDPerf は XDP の仕組みを利用した高性能なネットワークトラフィック生成ツールです。 send モードと recv モードの両方に対応し、ネットワークスループットやパケットレートの測定に活用できます。Go で単一バイナリとして実装されているため依存関係が少なく、容易に配布できます。

さらに、XDPerf はWASM ベースのプラグインを備え、任意のパケットを生成できます。この仕組みにより、Python ベースのツールでありがちな依存関係の問題を避けられます。

機能面から見ると、XDPerf は TRex と iperf の中間を狙ったような位置付けです。主な利点は次のとおりです。

  • TRex のような DPDK ほどの性能は出ない可能性がありますが、DPDK によくあるような Network Interface の占有が発生せず、ARP の解決などを Linux のレイヤで確認できます。
  • iperf のように状態遷移を持つTCP や輻輳制御などはありませんが、手軽に高い性能で負荷をかけることができ、(自作プラグイン経由で)任意のパケット送信することが利用できます。
  • TRex のような Python SDK は不要であり、WASM により任意のパケット生成ロジックを記述できるため、古い Python やライブラリを強制されることがありません。

使い方

次のワンライナーでインストールできます。

curl -fsSL https://raw.githubusercontent.com/takehaya/xdperf/main/scripts/install_xdperf.sh | sudo bash

任意パケットの PPS を手軽に測定する例は次のとおりです。 これは特定インタフェースから 10 万パケットを 4 並列で送信し、設定パラメーターに応じた UDP パケットを送信する例です。

sudo xdperf run --device eth0 --count 100k --parallelism 4 --plugin simpleudp.go \
    --cfg '{"dst_port": 10001, "src_ip": "192.168.1.1", "dst_ip": "192.168.1.2"}'

プラグインを差し替えることで動作を拡張できます。 次は imix パケットを送信する例です。

sudo xdperf run --device eth0 --count 100k --parallelism 4 --plugin imixudp.go \
    --cfg '{"dst_port": 10001, "src_ip": "192.168.1.1", "dst_ip": "192.168.1.2", "payload_size": 64}'

技術的背景

BPF_F_TEST_XDP_LIVE_FRAMES

XDPerfではXDPのBPF_PROG_RUNとBPF_F_TEST_XDP_LIVE_FRAMESを活用しています。BPF_F_TEST_XDP_LIVE_FRAMESを使用すると、高速パケット処理基盤である eBPF/XDP を通じてパケット送信のみを高速に実行できます。

利用例は次のようになります。

xdpmd := &sys.XdpMd{
  DataEnd:        uint32(len(pkt)),
  IngressIfindex: uint32(iface.Index),
}
ret, err := objs.XdpProgTx.Run(&ebpf.RunOptions{
  Data:      pkt,
  Repeat:    uint32(repeat),
  Flags:     unix.BPF_F_TEST_XDP_LIVE_FRAMES,
  Context:   xdpmd,
  BatchSize: uint32(batchSize),
})

実際にGo言語でやってみたい場合は、cilium/ebpfの ebpf/examples/xdp_live_frame が参考になります。

なお、この例は cilium/ebpf において BatchSize パラメーターが未サポートだった際、筆者が PR を提出したことを契機として取り込まれたものです。 github.com

また、BPF_F_TEST_XDP_LIVE_FRAMES の性能については開発者である tohojo 氏のブログで詳しく紹介されています。 1 コアで 8 Mpps、5 コアで 40 Mpps 程度の性能を発揮できる可能性があるとされています。

blog.tohojo.dk

より詳しい技術情報は Linux カーネルのドキュメントを参照してください。 docs.kernel.org

なお、XDPerf に付属のprobeコマンドを使うと対象インタフェースがXDPとともにBPF_F_TEST_XDP_LIVE_FRAMESをサポートしているか確認できます。

wazero

XDPerf は wazero という Go 製の WASM ランタイムを利用しています。 github.com

パケット生成部分をプラグインとして切り出しており、これを WASM バイナリとして実行するためです。

XDPerfで使うWASM プラグインは次の 3 つの関数を必ず実装します。

//go:wasmexport plugin_init
func plugin_init(inputPtr, inputLen, outputPtr, outputMaxLen uint32) int32 { ... }

//go:wasmexport plugin_process
func plugin_process(inputPtr, inputLen, outputPtr, outputMaxLen uint32) int32 { ... }

//go:wasmexport plugin_cleanup
func plugin_cleanup(inputPtr, inputLen, outputPtr, outputMaxLen uint32) int32 { ... }

このうち plugin_process においてベースパケットと動的に変化させる値を定義し、XDPerf 本体に返すことで処理を実現します。 そのため、任意の言語でパケット生成ロジックを記述できます。

XDPerfのアイディア

BPF_F_TEST_XDP_LIVE_FRAMES の制約に対応する仕組み

BPF_F_TEST_XDP_LIVE_FRAMES は単純に利用すると、登録した 1 種類のパケットを連続して送信するだけであり、多様なパケットを送出する用途には適しません。マルチフローのパケットを生成できないため実用性が限られます。

これに対して XDPerf では eBPF Map を利用し、送信したいパケットを動的に切り替える方式を採用しています。PerCPU Map を利用することで CPU 間の競合を避けつつ高速に処理できます。ただし、この方式では送信順序が前後する可能性があるため注意が必要です。

任意のパケットを投げる仕組み

先述のとおり、ベースパケットと変化させる変数を組み合わせる仕組みをテンプレートジェネレーターと呼んでいます。

例えば、これはsimpleudp.go から抜粋したものです。呼んでみるとわかりますがベースとなるパケットがあり、そこに対して変数が定義されています。ソースポートを動的に尚且つシーケンシャルに変更できるようにしてたり、パケットの長さをシーケンシャルに変更可能にしていたりします。これによって1つのベースのパケットを動的に変えながらパケットを送ることができるようになってます。

res := guest.GeneratorProcessResponse{
  TemplateType: guest.GeneratorTemplateTypeVariable,
  VariablePacketTemplate: guest.PacketVariantSet{
    Variants: []guest.PacketVariant{
      {
        Base: guest.BasePacket{
          Data:   packetBytes,
          Length: maxLen,
        },
        Params: []guest.VariableParams{
          {
            ByteStart:   srcPortOffset,
            ByteSize:    2,
            ByteRange:   guest.TemplateRange{Start: 1024, End: 1124},
            PatternType: guest.ValuePatternTypeSequential,
          },
          {
            ByteStart:   guest.ByteStartPacketLength,
            ByteSize:    0,
            ByteRange:   guest.TemplateRange{Start: 64, End: 84},
            PatternType: guest.ValuePatternTypeSequential,
          },
        },
      },
    },
    Pattern: guest.VariantSelectionModeSequential,
  },
}

これは単一パケットだけではなく、複数のパケットを選択したときはそれらの比率も定義可能です。

例えばこれは imixudp.go の例です。3種類のパケットをウェイトを決めてMixしています。

// create response
// imix pattern with 3 variants
// Variant A: Short packets (64-84 bytes), SrcPort 1024-1124, Weight=60%
// Variant B: Mid packets (500-600 bytes), SrcPort 2000-2100, Weight=34%
// Variant C: Large Packets with varying source IP (4 bytes, 1500 bytes), Weight=6%
// Total Weight = 100%
// can be overridden by req.IMIXRatio
// hint: https://github.com/cisco-system-traffic-generator/trex-core/blob/master/scripts/stl/imix.py
res := guest.GeneratorProcessResponse{
  TemplateType: guest.GeneratorTemplateTypeVariable,
  VariablePacketTemplate: guest.PacketVariantSet{
    Variants: []guest.PacketVariant{
      // Variant A: Short packets (64-84 bytes), SrcPort 1024-1124, Weight=60%
      {
        Base: guest.BasePacket{
          Data:   packetBytes,
          Length: maxLen,
        },
        Params: []guest.VariableParams{
          {
            ByteStart:   srcPortOffset,
            ByteSize:    2,
            ByteRange:   guest.TemplateRange{Start: 1024, End: 1124},
            PatternType: guest.ValuePatternTypeSequential,
          },
          {
            ByteStart:   guest.ByteStartPacketLength,
            ByteSize:    0,
            ByteRange:   guest.TemplateRange{Start: 64, End: 84}, // Short: 64-84 bytes
            PatternType: guest.ValuePatternTypeSequential,
          },
        },
        Weight: uint32(req.IMIXRatio[0]),
      },
      // Variant B: Mid packets (500-600 bytes), SrcPort 2000-2100, Weight=34%
      {
        Base: guest.BasePacket{
          Data:   packetBytes,
          Length: maxLen,
        },
        Params: []guest.VariableParams{
          {
            ByteStart:   srcPortOffset,
            ByteSize:    2,
            ByteRange:   guest.TemplateRange{Start: 2000, End: 2100},
            PatternType: guest.ValuePatternTypeSequential,
          },
          {
            ByteStart:   guest.ByteStartPacketLength,
            ByteSize:    0,
            ByteRange:   guest.TemplateRange{Start: 500, End: 600},
            PatternType: guest.ValuePatternTypeSequential,
          },
        },
        Weight: uint32(req.IMIXRatio[1]),
      },
      // Variant C: Varying source IP (4 bytes, 1500 bytes), Weight=6%
      {
        Base: guest.BasePacket{
          Data:   packetBytes,
          Length: maxLen,
        },
        Params: []guest.VariableParams{
          {
            ByteStart: v4srcIPOffset,
            ByteSize:  4,
            ByteRange: guest.TemplateRange{ // 192.168.1.1 - 192.168.1.254
              Start: uint64(IPv4ToUint32(net.ParseIP("192.168.1.1"))),
              End:   uint64(IPv4ToUint32(net.ParseIP("192.168.1.254"))),
            },
            PatternType: guest.ValuePatternTypeSequential,
          },
          {
            ByteStart:   guest.ByteStartPacketLength,
            ByteSize:    0,
            ByteRange:   guest.TemplateRange{Start: 1500, End: 1500},
            PatternType: guest.ValuePatternTypeSequential,
          },
        },
        Weight: uint32(req.IMIXRatio[2]),
      },
    },
    // VariantSelectionModeMixed: weighted selection (A 60%, B 34%, C 6%)
    Pattern: guest.VariantSelectionModeMixed,
  },
}

このエンジンで使えるパラメーターに関しては、詳しくはこちらをみてください。 github.com

終わりに

今後の展望

実はこのツールの最適化はまだまだできそうな感じです。 自分がvirtio_netで実験した限りでは50Mppsぐらいまでは出すことができましたが、memcpyのオーバーヘッドがかなりあることも色々調査をしてわかりました。 詳しくはここに書いています。 github.com

最適化方法としては、例えばパケットの割り当てアルゴリズムを事前生成ではなくXDPのレイヤで行うことでメモリ使用量を小さくできると考えています。また差分更新にすることでメモリコピーを小さくできるのでそこにも高速化の余地があります。また、sched_ext を使えば、SMP 環境における CPU 割り当てをより最大限に引き上げることができ、さらなる 性能Enhance も可能だと考えています。

また機能性やPluginの充実も狙っていきたいと思っています。もしもこの様なプラグインが欲しいなど、機能リクエストがありましたら自分までお問い合わせください。開発検討をしようと思います。良さげな機能の PR も歓迎します。

とりあえずSRv6やGTP-Uなどが投げれるようにしたいなと思ったりしています。 あとは過去に作った(企画した)拙作の xk6-gtp, xk6-diameterとか....GoodPutはわからないけど、そういうのが移植できる余地があってもいいかも知れません。

余談

このツールは eBPF Summit に併設された Hackathon をきっかけに、妻とともに開発を進めたものです。

アイデアやデザイン、フィジビリティ確認は筆者が行いましたが、この記事で紹介したテンプレートジェネレーターの実装などは妻の大きな貢献によるものでした、この場を借りてコントリビューションに感謝します。

また、XDPerfをHackathonの為に宣伝した際にリポジトリにスターをつけてくれた方にもこの場を借りて御礼申し上げます。

なお、Hackathonについては残念ながら賞は取れずでした。とほほ....ぜひまた機会があればHackathonに作品を出したいなと思っています。

Go Conference 2025で発表してきました

Why

今後もいろんなところでCFPを出していくぞ!というメモ書きとしてこれを残します。

※なお、この記事は所属企業団体を代表するものではなく、筆者自身の個人的な意見であることを書いておきます。

What

昨年は落ちたGo Conference 2025はCFPを通したい!と思ってプロポーザルを出したところ採択してもらいました。

goconのパネル

発表内容について

先日開催された Go Conference 2025 で、Goで体感するMultipath TCP ― Go 1.24 時代の MPTCP Listener を理解する というタイトルで登壇してきました。20分の公募 CFP 枠です。

gocon.jp

最後に公開された資料によると単純計算で 27/244 =おおよそ9倍、去年が5倍だったらしいです。

これは去年のyapcで出てた歴代最高のCFP数と言ってたやつで7倍だったのでそこよりも高いというのは相当ハイレベルなカンファレンスになってたことがわかります。

本当に選ばれるだけでも難しいところを選んでいただけたのは大変光栄です。

CFPを練るにあたっての所感

前述の通り昨年は公募CFP3本(GoCon, YAPC, CNDW)出して唯一落としたのがこのGoConでした。 去年はそのときは 最速のUDPConnを目指して というタイトルで出していました。 これはソケットとしてコンパチビリティを持つけど、裏側に高速パケット処理系を利用した物を使うという話を出していました。このときは残念ながら通過ならずで悲しい気持ちでした。

この経験から、採択されるセッションの多くが Go 言語そのものに近いテーマであることに気付きました。標準ライブラリの解説や有名ライブラリの詳細、PGO など、言語仕様や標準機能に関する話題が多くを占めていました。

いろいろ調べてみるとコロナ以前であれば Go で実装したネットワークコントローラー実装のような、いわゆる「やってみた!」みたいな事例も通っていましたが、傾向が変化していたと自分は思っています。

(※これに関してはいろんな意見があると思いますが、個人的には真っ直ぐに言語系のカンファレンスらしいイベントになってるなと思いました。そういうイベントのカラーだよなと思いますし、公開されてる利用ユースケースはいっぱいあるのでそれで良いんじゃないかなと思ったりしています。)

さて、そこで今回はGo のリリースノートを精査しそこから選ぶことにしました。具体的にはリリースノートから自分が知見を持ち、今話す意義がありそうなテーマを探しました。その結果選んだのが、net パッケージで TCP Listen 時に MPTCP がデフォルト有効化された変更です。 私は昨年、MPTCP の eBPF 拡張を活用した研究を行い、共著で論文やブログも執筆していたため、この分野で質の高い発表ができると判断しました。

www.ipsj.or.jp

blog.bbsakura.net

その結果、このプロポーザルは採択されました。

これは傾向に対しての分析を適切に行なって上でCfPを投稿したというのが良かったのだと思っています。

文章として意識づけたところとして、このようなポイントを意識づけています。

  • 明瞭さ:平易な文章で短くまとめる
  • インパクト:聴講者が持ち帰れる内容を明示
  • 適時性:なぜ今話すのかを事実と共に記述
  • 実現性:目安となるタイムテーブルを提示

書いたCFPは以下のとおりです。先程述べたポイントが抑えられてそうなのが理解できるのではないかと思います。

## Goで体感するMultipath TCP ― Go 1.24 時代の MPTCP Listener を理解する

本セッションでは、GoでMPTCPを利用するための方法と、MPTCPの基本的なアーキテクチャを解説し詳しく掘り下げます。
2025年現在、mptcp.ioの測定によるとMPTCPの実世界の利用規模はMPTCP v1で57万以上のIPが確認されています。代表的な例ではAppleやモバイルネットワークなど様々な所で利活用が進んでいます。
Goにおいてはv1.21(2023年)にGo標準のnetパッケージに導入されました。そして、Go v1.24(2025年)でTCPのListen時にデフォルトでMPTCPが有効化されるようになりました。クラウドネイティブ関連のサーバー&インフラソフトウェアで多く利用されるGoで有効化されたことで今後もより活用が進むことが考えられます。このことから、「Goを利用する開発者が今こそ学ぶべき技術である」と応募者である私は確信しています。
セッションを通じて、Go で書いた小さなサンプルとカーネル/ロードバランサ設定の注意点を紹介し、聴講後には自身の環境で MPTCP を動かすための最初の一歩を踏み出せる知識と手順を持ち帰れるようにすることを目指します。

想定している話の流れは以下の通りです  
- 3m: 自己紹介および、セッションの概要説明  
- 7m: MPTCPプロトコルの概説
- 5m: Goでの実装例
- 5m: 運用ノウハウやLinuxの観点からのチューニングポイント

想定してる聴講者は以下の通りです
- Go でネットワーク/バックエンドを開発するエンジニア
- SRE、プラットフォーム担当者
- マルチホーム・モバイル特性を活かしたいアプリ開発者

発表方法について

発表練習は個人で行い、スピーカーノートにはある程度文章でスクリプトを描きました。発表資料・言語は日本語なので緊張はしましたが話が飛んでしまうということはなかったかなと思います。

が、相変わらず話したことをいっぱい詰め込んだら早口になったためマシンガントークと言われてしまいました・・・トホホ(お聞き苦しくすいませぬ・・・)

当日の発表は200人近い人の前で話すことになり流石に緊張しました・・・

終わりに

そうえば、今回は所属企業として初めてスポンサー応募を出して、ブロンズスポンサーを務めました。本当はゴールドスポンサーを目指していたのですが、残念ながら抽選に漏れてしまいました。通る気満々でTシャツとか作って参加してたので、来年はぜひブース出展まで実現できると嬉しいですね笑

また、若手メンバーの学習の一環としてイベントに同行してもらいました。いろんな人の発表に関する感想については、若手の同僚達が記事にまとめてくれているので、ぜひそちらをご覧いただければと思います。(PV数が彼らの励みになります :bow: :bow: )

blog.bbsakura.net

個人的には前述の通り昨年のリベンジができて良かったなと思いました。 運営の皆さん、大変素晴らしいイベントでした。ありがとうございました!!!

今後もイベント登壇を通じてコミュニティに貢献していきたいなと思います!